Mixture of Experts: come un modello AI attiva solo gli esperti giusti
Per anni l'intuizione sui modelli AI e' stata semplice: piu' grande, piu' capace. Ma c'e' un costo nascosto, perche' ogni risposta accende l'intero modello anche per la domanda piu' banale. Il Mixture of Experts (una miscela di esperti) rompe questo legame: divide la conoscenza in tante sotto-reti specializzate e ne attiva solo alcune per volta, scelte da un router interno. Cosi' un modello puo' essere enorme nel sapere complessivo e leggero in cio' che usa a ogni risposta. Ma resta un solo modello, con una sola visione del problema: il router sceglie tra esperti che condividono lo stesso addestramento. Per le decisioni che contano il limite non e' l'efficienza, e' la prospettiva unica — ed e' il salto che porta ad Arena.
di Redazione AI Arena
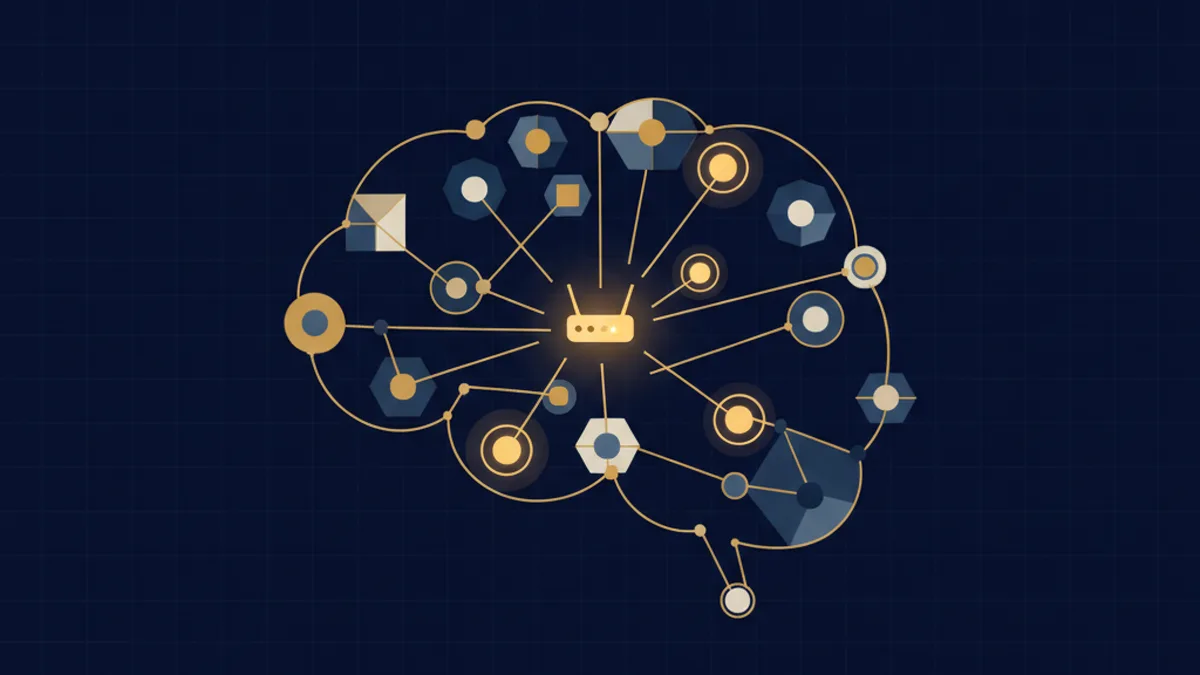
Per anni l'intuizione dominante sui modelli AI e' stata semplice: piu' grande, piu' capace. Aumenti i parametri, il modello sa fare di piu'. Ma dentro questa corsa alla dimensione si nasconde un costo che raramente viene raccontato: ogni volta che il modello risponde usa tutto se stesso, ogni singolo parametro, anche per la domanda piu' banale. E' come accendere un intero stabilimento per avvitare una vite. Il Mixture of Experts, spesso abbreviato in MoE, nasce proprio per rompere questo legame tra dimensione e costo — un modello puo' essere enorme nel sapere complessivo e leggero in cio' che attiva davvero a ogni risposta.
Un modello che non usa tutto se stesso ogni volta
L'idea di fondo del Mixture of Experts (una miscela di esperti) e' dividere la conoscenza del modello in tante sotto-reti specializzate, gli esperti, e mettere al lavoro solo quelle che servono per una data richiesta. Non e' un insieme di modelli separati: e' un unico modello al cui interno convivono molti blocchi, ciascuno diventato bravo in una porzione del lavoro durante l'addestramento. Uno puo' essersi sintonizzato sul codice, un altro su un certo tipo di ragionamento, un altro ancora su una particolare sfumatura della lingua — anche se nella pratica queste specializzazioni sono piu' sfumate e meno leggibili di come le raccontiamo a parole.
Quando arriva una richiesta, il modello non chiama tutti gli esperti. Ne seleziona un piccolo sottoinsieme, i piu' pertinenti, e lascia gli altri spenti. Il risultato e' che un modello con una capacita' complessiva enorme, sulla singola risposta, ne mette in campo solo una frazione. La conoscenza totale resta grande; il conto da pagare a ogni domanda resta piccolo. E' questa la mossa che rende il MoE cosi' interessante: disaccoppia quanto un modello sa da quanto costa usarlo.
Il router che decide chi lavora
Il pezzo che tiene in piedi tutto e' il router, a volte chiamato gating: un piccolo meccanismo interno che, per ogni pezzo di testo in ingresso, decide a quali esperti passarlo. Non e' una regola scritta a mano da un ingegnere, e' qualcosa che il modello ha imparato insieme al resto durante l'addestramento. Col tempo il router capisce che un certo tipo di input rende meglio se instradato verso certi esperti, e affina questa scelta a ogni passaggio.
Questo instradamento e' la parte piu' delicata dell'architettura. Se il router manda quasi tutto sempre agli stessi due o tre esperti, gli altri restano inutili e la capacita' extra e' sprecata; se distribuisce a caso, perde il vantaggio della specializzazione. Per questo addestrare un MoE richiede accorgimenti che tengano il carico bilanciato, in modo che tutti gli esperti vengano usati e nessuno diventi un collo di bottiglia. Vale la pena fermarsi su un punto, perche' e' quello che conta davvero piu' avanti: anche quando l'instradamento funziona alla perfezione, resta comunque un solo modello a decidere come leggere il problema. Il router sceglie tra esperti che condividono lo stesso addestramento e la stessa visione del mondo. E' efficienza interna, non pluralita' di prospettive.
Potenza senza pagare tutto il conto
Il motivo per cui il Mixture of Experts e' diventato centrale nei modelli piu' recenti e' pratico prima ancora che teorico. Permette di far crescere il sapere complessivo di un sistema — piu' esperti, piu' competenze coperte — senza far crescere in proporzione il costo e la lentezza di ogni risposta. E' un modo per aggirare il compromesso tra qualita' e velocita' che altrimenti obbligherebbe a scegliere: o un modello grande e lento, o uno piccolo e rapido. Con il MoE si prova ad avere entrambe le cose, ampiezza di competenza e leggerezza sulla singola risposta.
Da qui emerge un cambiamento piu' ampio nella direzione dell'AI. Per anni si e' inseguita la dimensione come unica leva; oggi la ricerca si sposta su come organizzare quella dimensione — quali parti attivare, quando, con quale criterio. Il MoE e' uno dei primi segnali di questa maturazione: non basta un cervello piu' grande, serve un cervello che sappia usare la parte giusta di se' al momento giusto. E' un principio che somiglia a come funzionano i sistemi complessi in generale, dove l'intelligenza non sta solo nelle singole componenti, ma soprattutto nel modo in cui vengono coordinate.
Dove va il mondo, e Arena come conclusione naturale
Il Mixture of Experts risolve un problema di efficienza dentro un singolo modello: come dare tanta competenza senza pagarla per intero a ogni risposta. Ma resta, appunto, dentro un modello — un solo addestramento, una sola impostazione, una sola idea di cosa conti in un problema. Gli esperti che il router seleziona sono variazioni della stessa mente, non punti di vista diversi. Per molte richieste questo basta e avanza. Per le decisioni che contano, no: li' il limite non e' l'efficienza, e' la prospettiva unica.
Ed e' esattamente il salto che porta ad Arena. AI Arena e' la piattaforma che mette a confronto piu' identita' AI con prospettive diverse sullo stesso problema, ti fa selezionare le risposte piu' utili e usa un Orchestrator per portarti al passo successivo, non sostituisce la tua decisione, te la fa prendere con piu' consapevolezza. Se il MoE sceglie esperti dentro una sola testa, Arena mette a confronto teste diverse: scegli il team, porti la tua domanda, e 7 specialisti complementari scrivono ciascuno la propria lettura, con prospettive complementari che un modello solo — per quanto ben instradato — non puo' avere da se'. Tu selezioni cio' che regge, il sistema affina e approfondisce, e l'Orchestrator, il meta-layer che tiene insieme il flusso, ti accompagna fino alla relazione conclusiva. L'efficienza interna di un modello e' un conto; il confronto tra visioni diverse e' un altro, e per le scelte che pesano e' quello che fa la differenza.
Entra in Arena.
FAQ
Che cos e il Mixture of Experts in un modello AI?
Il Mixture of Experts, spesso abbreviato in MoE, e una miscela di esperti: un modo di costruire un modello AI dividendo la sua conoscenza in tante sotto-reti specializzate, chiamate esperti, invece di tenerla in un unico blocco indistinto. Non si tratta di modelli separati messi insieme, ma di un solo modello al cui interno convivono molti esperti, ciascuno diventato bravo in una porzione del lavoro durante l addestramento. La caratteristica chiave e che, per ogni richiesta, il modello attiva solo un piccolo sottoinsieme di esperti e lascia spenti gli altri. Cosi la conoscenza complessiva puo essere enorme, mentre cio che il modello usa davvero a ogni singola risposta resta una frazione.
Come fa un modello MoE a scegliere quali esperti usare?
Il compito spetta a un componente interno chiamato router, o gating. Per ogni pezzo di testo in ingresso, il router decide a quali esperti passarlo, instradando la richiesta verso i piu pertinenti. Non e una regola scritta a mano: e qualcosa che il modello ha imparato durante l addestramento, insieme al resto. Col tempo il router capisce che certi tipi di input rendono meglio se mandati a certi esperti. E la parte piu delicata dell architettura, perche se instradasse tutto sempre agli stessi la capacita extra andrebbe sprecata, e se distribuisse a caso perderebbe il vantaggio della specializzazione.
Perche il Mixture of Experts rende un modello piu efficiente?
Perche separa la dimensione complessiva del modello dal costo di ogni singola risposta. In un modello tradizionale ogni parametro viene usato a ogni richiesta, quindi far crescere il sapere significa far crescere in proporzione anche costo e lentezza. Con il MoE si possono aggiungere esperti, e quindi competenze, senza attivarli tutti insieme: a ogni risposta lavora solo la parte selezionata. E un modo per aggirare il compromesso tra qualita e velocita, che altrimenti costringerebbe a scegliere tra un modello grande e lento o uno piccolo e rapido.
Un modello Mixture of Experts e come usare piu modelli AI insieme?
No, ed e una distinzione importante. In un MoE gli esperti sono parti di un unico modello, nate dallo stesso addestramento e con la stessa impostazione di fondo: il router sceglie tra variazioni della stessa mente, non tra punti di vista diversi. E efficienza interna, non pluralita di prospettive. Usare piu AI diverse insieme e un altra cosa: significa mettere a confronto identita distinte, addestrate e impostate in modo diverso, che leggono lo stesso problema da angolazioni davvero differenti. Il MoE ottimizza come un singolo modello usa se stesso, il confronto tra piu AI aggiunge la varieta di visioni che un solo modello non puo avere.
Come si collega il Mixture of Experts al confronto tra piu AI di Arena?
AI Arena e la piattaforma che mette a confronto piu identita AI con prospettive diverse sullo stesso problema, ti fa selezionare le risposte piu utili e usa un Orchestrator per portarti al passo successivo, non sostituisce la tua decisione, te la fa prendere con piu consapevolezza. Il MoE risolve un problema di efficienza dentro una sola mente, scegliendo quali esperti attivare, ma resta una prospettiva unica. Arena lavora al livello sopra: scegli il team e 7 specialisti complementari scrivono ciascuno la propria lettura, con prospettive complementari che un modello solo non puo avere. Tu selezioni cio che regge, il sistema affina e approfondisce, e l Orchestrator tiene insieme il flusso fino alla relazione conclusiva.
Argomenti