Mixture of Experts: Wie ein KI-Modell nur die richtigen Experten aktiviert
Jahrelang war die Intuition zu KI-Modellen simpel: je größer, desto leistungsfähiger. Doch es gibt versteckte Kosten, denn jede Antwort schaltet das gesamte Modell ein, selbst für die banalste Frage. Mixture of Experts durchbricht diese Kopplung: Es teilt das Wissen in viele spezialisierte Teilnetze auf und aktiviert pro Antwort nur einige davon, ausgewählt von einem internen Router. So kann ein Modell im Gesamtwissen riesig und in dem, was es je Antwort nutzt, leicht sein. Doch es bleibt ein einziges Modell mit einer einzigen Sicht auf das Problem: Der Router wählt zwischen Experten, die dasselbe Training teilen. Bei Entscheidungen, die zählen, ist die Grenze nicht die Effizienz, sondern die einzige Perspektive — und genau das ist der Sprung, der zu Arena führt.
von Redazione AI Arena
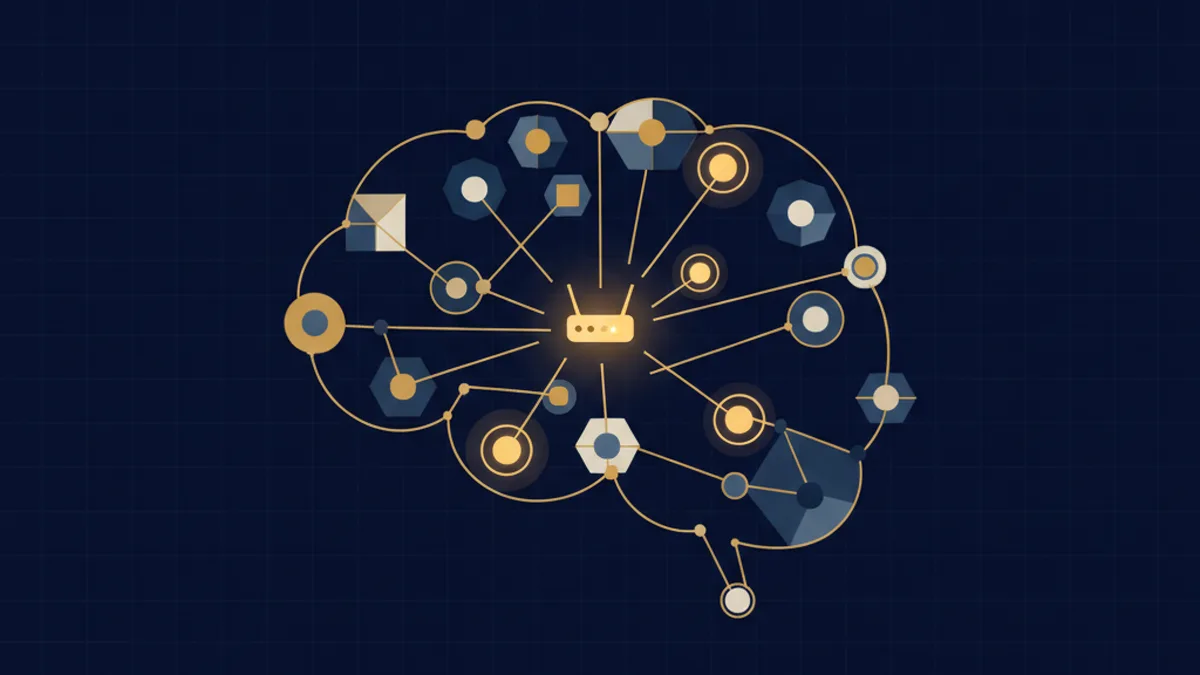
Jahrelang war die vorherrschende Intuition zu KI-Modellen simpel: je größer, desto leistungsfähiger. Man erhöht die Parameter, und das Modell kann mehr. Doch in diesem Wettlauf um Größe verbirgt sich ein Preis, der selten erzählt wird: Jedes Mal, wenn das Modell antwortet, nutzt es sich vollständig, jeden einzelnen Parameter, selbst für die banalste Frage. Es ist, als würde man eine ganze Fabrik anwerfen, um eine Schraube anzuziehen. Mixture of Experts, oft mit MoE abgekürzt, entsteht genau dafür: um diese Kopplung zwischen Größe und Kosten zu durchbrechen — ein Modell kann im Gesamtwissen riesig und in dem, was es je Antwort tatsächlich aktiviert, leicht sein.
Ein Modell, das nicht jedes Mal sich selbst vollständig nutzt
Die Grundidee von Mixture of Experts (einer Mischung von Experten) besteht darin, das Wissen des Modells in viele spezialisierte Teilnetze aufzuteilen, die Experten, und nur jene an die Arbeit zu setzen, die für eine bestimmte Anfrage gebraucht werden. Es ist keine Ansammlung getrennter Modelle: Es ist ein einziges Modell, in dessen Innerem viele Blöcke koexistieren, von denen jeder während des Trainings in einem Teil der Arbeit gut geworden ist. Einer mag sich auf Code eingestellt haben, ein anderer auf eine bestimmte Art des Denkens, wieder ein anderer auf eine besondere sprachliche Nuance — auch wenn diese Spezialisierungen in der Praxis fließender und weniger klar ablesbar sind, als wir sie in Worten schildern.
Wenn eine Anfrage eintrifft, ruft das Modell nicht alle Experten auf. Es wählt eine kleine Teilmenge aus, die relevantesten, und lässt die übrigen abgeschaltet. Das Ergebnis ist, dass ein Modell mit einer riesigen Gesamtkapazität bei der einzelnen Antwort nur einen Bruchteil davon ins Feld führt. Das Gesamtwissen bleibt groß; die Rechnung, die bei jeder Frage zu zahlen ist, bleibt klein. Das ist der Zug, der MoE so interessant macht: Es entkoppelt, wie viel ein Modell weiß, von dem, was es kostet, es zu nutzen.
Der Router, der entscheidet, wer arbeitet
Das Stück, das alles zusammenhält, ist der Router, manchmal Gating genannt: ein kleiner interner Mechanismus, der für jedes eingehende Textstück entscheidet, an welche Experten es weitergeleitet wird. Es ist keine von einem Ingenieur von Hand geschriebene Regel, sondern etwas, das das Modell zusammen mit dem Rest während des Trainings gelernt hat. Mit der Zeit begreift der Router, dass eine bestimmte Art von Eingabe besser funktioniert, wenn sie zu bestimmten Experten geleitet wird, und verfeinert diese Wahl bei jedem Durchgang.
Diese Weiterleitung ist der heikelste Teil der Architektur. Schickt der Router fast alles immer an dieselben zwei oder drei Experten, bleiben die übrigen nutzlos und die zusätzliche Kapazität ist verschwendet; verteilt er zufällig, verliert er den Vorteil der Spezialisierung. Deshalb erfordert das Training eines MoE Vorkehrungen, die die Last ausgewogen halten, sodass alle Experten genutzt werden und keiner zum Engpass wird. Es lohnt sich, bei einem Punkt zu verweilen, denn er ist es, der weiter unten wirklich zählt: Selbst wenn die Weiterleitung perfekt funktioniert, bleibt es dennoch ein einziges Modell, das entscheidet, wie das Problem zu lesen ist. Der Router wählt zwischen Experten, die dasselbe Training und dieselbe Weltsicht teilen. Das ist interne Effizienz, keine Vielfalt an Perspektiven.
Leistung, ohne die ganze Rechnung zu zahlen
Der Grund, warum Mixture of Experts in den jüngsten Modellen zentral geworden ist, ist praktisch, noch bevor er theoretisch ist. Es erlaubt, das Gesamtwissen eines Systems wachsen zu lassen — mehr Experten, mehr abgedeckte Kompetenzen — ohne die Kosten und die Langsamkeit jeder Antwort proportional wachsen zu lassen. Es ist ein Weg, den Kompromiss zwischen Qualität und Geschwindigkeit zu umgehen, der sonst zur Wahl zwingen würde: entweder ein großes und langsames Modell oder ein kleines und schnelles. Mit MoE versucht man, beides zu haben, Breite der Kompetenz und Leichtigkeit bei der einzelnen Antwort.
Daraus tritt eine umfassendere Veränderung in der Richtung der KI hervor. Jahrelang jagte man der Größe als einzigem Hebel nach; heute verschiebt sich die Forschung darauf, wie man diese Größe organisiert — welche Teile aktiviert werden, wann, nach welchem Kriterium. MoE ist eines der ersten Signale dieser Reifung: Ein größeres Gehirn genügt nicht, es braucht ein Gehirn, das den richtigen Teil seiner selbst im richtigen Moment zu nutzen weiß. Es ist ein Prinzip, das dem ähnelt, wie komplexe Systeme im Allgemeinen funktionieren, wo die Intelligenz nicht nur in den einzelnen Komponenten steckt, sondern vor allem in der Art, wie sie koordiniert werden.
Wohin die Welt geht, und Arena als natürlicher Abschluss
Mixture of Experts löst ein Effizienzproblem innerhalb eines einzelnen Modells: wie man viel Kompetenz gibt, ohne sie bei jeder Antwort vollständig zu bezahlen. Doch es bleibt eben innerhalb eines Modells — ein einziges Training, eine einzige Ausrichtung, eine einzige Vorstellung davon, was bei einem Problem zählt. Die Experten, die der Router auswählt, sind Variationen desselben Kopfes, keine unterschiedlichen Sichtweisen. Für viele Anfragen reicht das mehr als aus. Für Entscheidungen, die zählen, nicht: Dort ist die Grenze nicht die Effizienz, sondern die einzige Perspektive.
Und genau das ist der Sprung, der zu Arena führt. AI Arena ist die Plattform, die mehrere KI-Identitäten mit unterschiedlichen Perspektiven auf dasselbe Problem gegenüberstellt, dich die nützlichsten Antworten auswählen lässt und einen Orchestrator nutzt, um dich zum nächsten Schritt zu führen. Sie ersetzt deine Entscheidung nicht, sondern lässt dich sie mit mehr Bewusstsein treffen. Wenn MoE Experten in einem einzigen Kopf auswählt, stellt Arena verschiedene Köpfe gegenüber: Du wählst das Team, bringst deine Frage ein, und 7 komplementäre Spezialisten schreiben jeweils ihre eigene Lesart, mit komplementären Perspektiven, die ein einzelnes Modell — so gut auch weitergeleitet — nicht von sich aus haben kann. Du wählst aus, was standhält, das System verfeinert und vertieft, und der Orchestrator, das Meta-Layer, das den Fluss zusammenhält, begleitet dich bis zum abschließenden Bericht. Die interne Effizienz eines Modells ist die eine Rechnung; der Vergleich zwischen verschiedenen Sichtweisen ist eine andere, und für die Entscheidungen, die Gewicht haben, ist es der Unterschied, der zählt.
Tritt Arena bei.
FAQ
Was ist Mixture of Experts in einem KI-Modell?
Mixture of Experts, oft mit MoE abgekürzt, ist eine Mischung von Experten: eine Art, ein KI-Modell zu bauen, indem man sein Wissen in viele spezialisierte Teilnetze aufteilt, die man Experten nennt, statt es in einem einzigen ununterscheidbaren Block zu halten. Es geht nicht um getrennte Modelle, die zusammengesetzt werden, sondern um ein einziges Modell, in dessen Innerem viele Experten koexistieren, von denen jeder während des Trainings in einem Teil der Arbeit gut geworden ist. Das entscheidende Merkmal ist, dass das Modell für jede Anfrage nur eine kleine Teilmenge von Experten aktiviert und die übrigen abgeschaltet lässt. So kann das Gesamtwissen riesig sein, während das, was das Modell bei jeder einzelnen Antwort wirklich nutzt, ein Bruchteil bleibt.
Wie wählt ein MoE-Modell aus, welche Experten es nutzt?
Diese Aufgabe übernimmt eine interne Komponente namens Router oder Gating. Für jedes eingehende Textstück entscheidet der Router, an welche Experten es weitergeleitet wird, und leitet die Anfrage zu den relevantesten. Es ist keine von Hand geschriebene Regel: Es ist etwas, das das Modell während des Trainings zusammen mit dem Rest gelernt hat. Mit der Zeit begreift der Router, dass bestimmte Arten von Eingaben besser funktionieren, wenn sie an bestimmte Experten gehen. Das ist der heikelste Teil der Architektur, denn würde er alles immer an dieselben leiten, ginge die zusätzliche Kapazität verloren, und würde er zufällig verteilen, verlöre er den Vorteil der Spezialisierung.
Warum macht Mixture of Experts ein Modell effizienter?
Weil es die Gesamtgröße des Modells von den Kosten jeder einzelnen Antwort entkoppelt. In einem herkömmlichen Modell wird jeder Parameter bei jeder Anfrage genutzt, das Wissen wachsen zu lassen bedeutet also, auch Kosten und Langsamkeit proportional wachsen zu lassen. Mit MoE lassen sich Experten und damit Kompetenzen hinzufügen, ohne sie alle gemeinsam zu aktivieren: Bei jeder Antwort arbeitet nur der ausgewählte Teil. Es ist ein Weg, den Kompromiss zwischen Qualität und Geschwindigkeit zu umgehen, der sonst die Wahl zwischen einem großen und langsamen oder einem kleinen und schnellen Modell erzwingen würde.
Ist ein Mixture-of-Experts-Modell wie die Nutzung mehrerer KI-Modelle zusammen?
Nein, und das ist eine wichtige Unterscheidung. In einem MoE sind die Experten Teile eines einzigen Modells, aus demselben Training entstanden und mit derselben Grundausrichtung: Der Router wählt zwischen Variationen desselben Kopfes, nicht zwischen unterschiedlichen Sichtweisen. Das ist interne Effizienz, keine Vielfalt an Perspektiven. Mehrere verschiedene KIs zusammen zu nutzen ist etwas anderes: Es bedeutet, eigenständige Identitäten zu vergleichen, unterschiedlich trainiert und ausgerichtet, die dasselbe Problem aus wirklich verschiedenen Blickwinkeln lesen. MoE optimiert, wie ein einzelnes Modell sich selbst nutzt, der Vergleich mehrerer KIs fügt die Vielfalt an Sichtweisen hinzu, die ein einzelnes Modell nicht haben kann.
Wie hängt Mixture of Experts mit dem Vergleich mehrerer KIs bei Arena zusammen?
AI Arena ist die Plattform, die mehrere KI-Identitäten mit unterschiedlichen Perspektiven auf dasselbe Problem gegenüberstellt, dich die nützlichsten Antworten auswählen lässt und einen Orchestrator nutzt, um dich zum nächsten Schritt zu führen. Sie ersetzt deine Entscheidung nicht, sondern lässt dich sie mit mehr Bewusstsein treffen. MoE löst ein Effizienzproblem innerhalb eines einzigen Kopfes, indem es entscheidet, welche Experten aktiviert werden, bleibt aber eine einzige Perspektive. Arena arbeitet auf der Ebene darüber: Du wählst das Team, und 7 komplementäre Spezialisten schreiben jeweils ihre eigene Lesart, mit komplementären Perspektiven, die ein einzelnes Modell nicht haben kann. Du wählst aus, was standhält, das System verfeinert und vertieft, und der Orchestrator hält den Fluss bis zum abschließenden Bericht zusammen.
Themen