Tag
Wie ein LLM funktioniert
Token, Embeddings, Attention: was in einem Sprachmodell wirklich passiert.
11 · Artikel zu diesem Thema
Die Parameter eines KI-Modells: Was die Milliarden wirklich bedeuten
Bei jedem neuen KI-Modell liest man zuerst eine Zahl: Milliarden von Parametern, als wäre es der Hubraum eines Motors. Doch was sind diese Parameter eigentlich, und vor allem: sagt diese Zahl wirklich das aus, was sie zu versprechen scheint? In diesem Beitrag klären wir ohne Fachchinesisch, was ein Parameter ist, warum größer nicht gleich richtiger heißt, was jenseits der reinen Größe eines Modells wirklich zählt und warum der kluge Schritt nicht darin besteht, das größte Modell zu suchen, sondern ergänzende Perspektiven auf dasselbe Problem gegenüberzustellen — bis der Faden zu Arena führt.
Den Output vor der Nutzung noch einmal lesen: die letzte Kontrolle bleibt menschlich
Ein KI-Modell liefert saubere, selbstsichere, gut geschriebene Texte – und genau diese Flüssigkeit ist der heikelste Punkt: Ein Output, der gut klingt, wirkt schon fertig, und die Versuchung ist groß, ihn ungelesen zu kopieren und einzufügen. Doch die Qualität der Form ist nicht die Qualität des Inhalts. Vor der Nutzung noch einmal zu lesen ist kein bürokratischer Schritt und kein Zeichen von Misstrauen gegenüber dem Werkzeug: Es ist die letzte Kontrolle, die menschlich bleibt, und sie verändert, wie eine KI-Antwort zu deiner Entscheidung wird. In diesem Beitrag zeigen wir, warum ein überzeugender Output kein geprüfter Output ist, worauf du beim Nachlesen wirklich achten solltest und warum diese Geste eine Methode ist und keine Zeitverschwendung – bis hin zu dem Punkt, an dem der Gedanke zu Arena führt.
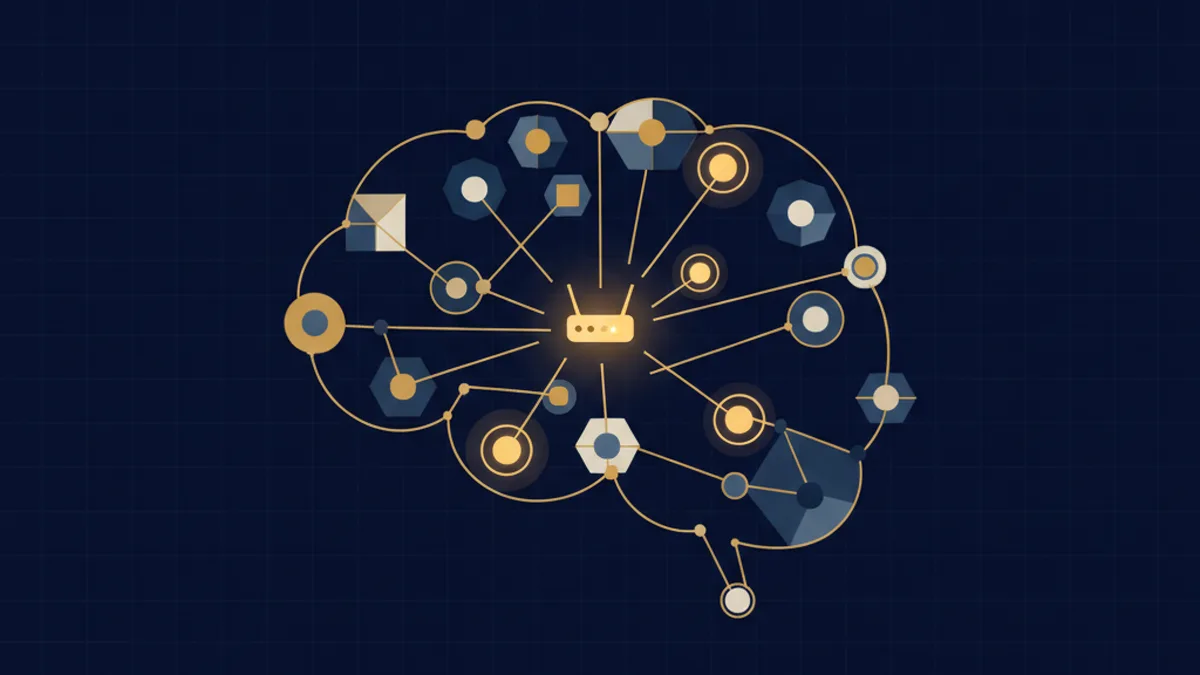
Mixture of Experts: Wie ein KI-Modell nur die richtigen Experten aktiviert
Jahrelang war die Intuition zu KI-Modellen simpel: je größer, desto leistungsfähiger. Doch es gibt versteckte Kosten, denn jede Antwort schaltet das gesamte Modell ein, selbst für die banalste Frage. Mixture of Experts durchbricht diese Kopplung: Es teilt das Wissen in viele spezialisierte Teilnetze auf und aktiviert pro Antwort nur einige davon, ausgewählt von einem internen Router. So kann ein Modell im Gesamtwissen riesig und in dem, was es je Antwort nutzt, leicht sein. Doch es bleibt ein einziges Modell mit einer einzigen Sicht auf das Problem: Der Router wählt zwischen Experten, die dasselbe Training teilen. Bei Entscheidungen, die zählen, ist die Grenze nicht die Effizienz, sondern die einzige Perspektive — und genau das ist der Sprung, der zu Arena führt.
Semantische Suche: Wie eine KI die Bedeutung hinter den Worten versteht
Jahrzehntelang bedeutete Suchen, Wörter abzugleichen: Man tippt einen Begriff ein, das System findet die Dokumente, die genau denselben Begriff enthalten. Die semantische Suche ändert die Spielregeln. Sie jagt nicht den Wörtern nach, sondern der Bedeutung: Sie erkennt, dass eine auf eine Weise gestellte Frage und eine anders formulierte Antwort dieselbe Sache meinen können, auch ohne ein einziges gemeinsames Wort. Hinter diesem Sprung steht eine andere Art, Sprache abzubilden, die es einer KI erlaubt zu finden, was du meinst, und nicht nur, was du tippst. Zu verstehen, wie das funktioniert, hilft, die Systeme besser zu lesen, die wir täglich nutzen, und zu begreifen, warum der Vergleich mehrerer Perspektiven der entscheidende Schritt bleibt.
Der System-Prompt: Was ein KI-Modell wirklich steuert
Wenn du einem KI-Assistenten schreibst, startest du nie mit einem leeren Blatt: Noch bevor deine Frage ankommt, hat das Modell bereits einen Satz Anweisungen erhalten, den du nicht siehst. Er heißt System-Prompt und ist die Schicht, die festlegt, wer das Modell ist, wie es schreibt und was es darf. Das zu verstehen erklärt, warum dir zwei KIs auf dieselbe Frage so unterschiedlich antworten.
Tokenisierung: wie ein KI-Modell Text wirklich liest
Wenn du einen Satz liest, zerlegst du ihn unbemerkt in Wörter und baust auf diesen Teilen den Sinn auf. Ein KI-Modell tut etwas Ähnliches, noch bevor es irgendetwas versteht, doch die Teile, in die es den Text zerlegt, sind nicht unsere Wörter: es sind Token, Fragmente, die ein ganzes Wort oder nur einen Teil davon umfassen können. Dieser erste Schnitt hat einen Namen, Tokenisierung (tokenization), und er ist die unsichtbare Handlung, von der alles Weitere abhängt: was eine Antwort kostet, wie viel Text zusammengehalten werden kann, wo das Modell stolpert. Zu verstehen, wie ein Modell Text zerlegt, hilft, die Vorstellung aufzulösen, es lese wie wir, und zeigt, warum eine einzige Art zu schneiden auch eine einzige Sichtweise ist. Daraus entsteht der Wert, mehrere Perspektiven gegenüberzustellen.
Attention: Wie ein KI-Modell entscheidet, was in einem Satz zählt
Wenn du einen Satz liest, gibst du nicht jedem Wort dasselbe Gewicht: manche lässt du vorbeiziehen, bei anderen hältst du inne, und den Sinn erschließt du gerade daraus, wie du sie miteinander verknüpfst. Ein KI-Modell tut etwas Ähnliches, und das hat einen präzisen Namen: Attention. Es ist der Mechanismus, mit dem ein Modell beim Verarbeiten eines Textes bestimmt, welche Wörter am meisten zählen, um die anderen zu deuten, und der die Bedeutung zusammenhält, statt Wort für Wort flach zu lesen. Diese Idee zu verstehen räumt mit einem verbreiteten Missverständnis auf: dass das Modell liest wie wir. Es liest nicht, es gewichtet. Und die Art, wie es Wörter gewichtet, ist zugleich seine tiefste Grenze, weil es nur eine einzige Weise ist, zu entscheiden, was zählt. Genau hier liegt der Wert, mehrere Perspektiven gegenüberzustellen, statt sich auf eine einzige Lesart zu verlassen.
Embeddings: Wie ein KI-Modell Bedeutung ordnet
Wenn du einem KI-System einen Satz schreibst, geschieht noch bevor es antwortet etwas Unsichtbares: Deine Worte werden in Zahlen verwandelt, in Koordinaten innerhalb eines Raums. Dieser Schritt hat einen Namen, Embedding, und er ist einer der Bausteine, auf denen fast alles ruht, was KI heute kann, von der Suche nach Bedeutung bis zur Fähigkeit, weit entfernte Ideen zu verbinden. Das ist kein Detail nur für Fachleute: Grob zu verstehen, wie ein Modell Begriffe in diesem Raum anordnet, hilft zu begreifen, warum ihm manche Dinge hervorragend gelingen und andere es im Stich lassen. Das Modell kennt die Welt nicht so, wie du sie kennst, aber es hat eine Landkarte der Bedeutung, und diese Karte erklärt viel von seinem Verhalten. Es lohnt sich, ohne Fachjargon hineinzuschauen, um KI bewusster zu nutzen.
Temperatur: Warum dieselbe Frage an die KI unterschiedliche Antworten liefert
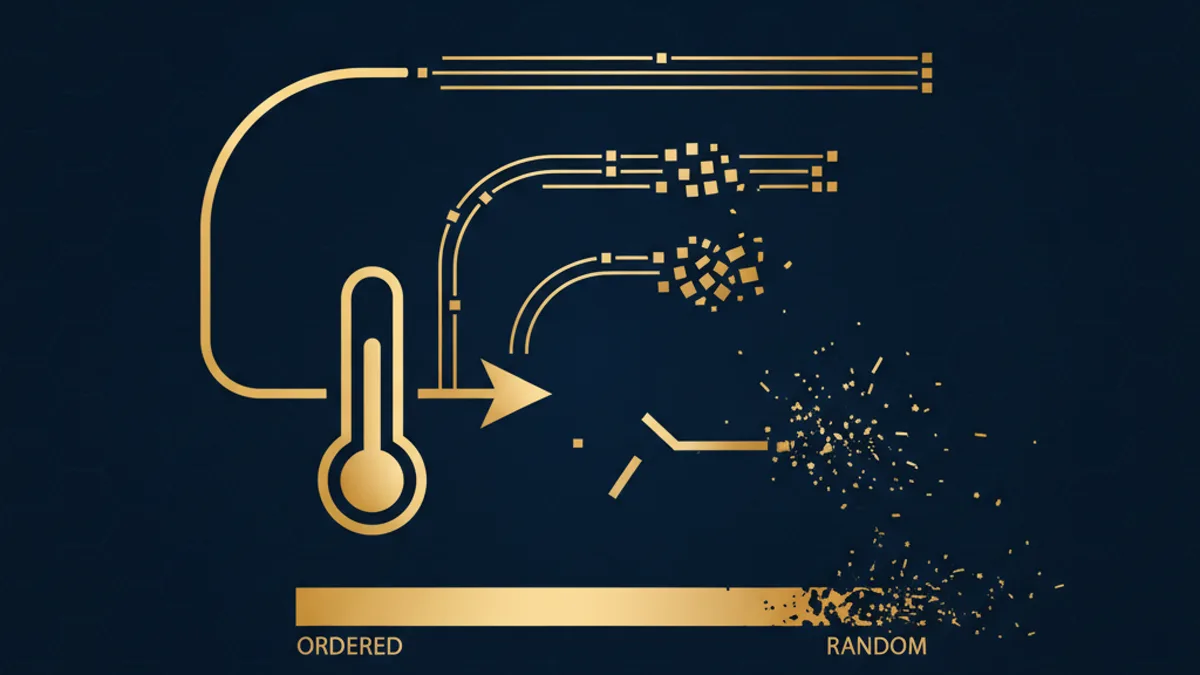
Stellst du einem KI-System zweimal dieselbe Frage, kannst du zwei verschiedene Antworten bekommen. Das ist weder ein Fehler noch eine Laune: Es ist eine bewusste Designentscheidung, gesteuert von einem Parameter namens Temperatur. Die Temperatur regelt, wie viel Freiheit sich das Modell bei der Wahl des nächsten Wortes nimmt: niedrig, und die Antworten werden vorhersehbar und wiederholbar, hoch, und sie werden vielfältig und kreativ, aber weniger stabil. Wer diesen Parameter versteht, versteht schlagartig viele Dinge, die seltsam wirken: warum ein Modell manchmal erfindet, warum zwei Versuche nicht übereinstimmen, warum dieselbe Anfrage einmal besser und einmal schlechter gelingt. Das ist kein Detail für Techniker: Es ist der Grund, warum du ein KI-System nicht an einer einzigen Antwort messen kannst und warum der Vergleich mehrerer Perspektiven mehr zählt als der einzelne glückliche Versuch.
Wenn KIs sich uneinig sind: Uneinigkeit ist ein Signal, kein Fehler
Wenn mehrere KI-Modelle beim selben Problem voneinander abweichen, ist die Divergenz kein zu glättender Fehler: Sie ist eine Information darüber, dass das Terrain unsicher oder umstritten ist. Wer sich auf eine einzige KI verlässt, verliert dieses Signal. Wer komplementäre Perspektiven vergleicht, verwandelt Uneinigkeit in fundiertere, weniger fragile Entscheidungen.
Schmeichelei: Warum generative Modelle dazu neigen, dem Nutzer zu schmeicheln
sycophancy – also die Tendenz von KI-Modellen, dem Nutzer zu gefallen – ist kein moralischer Mangel. Es handelt sich um einen strukturellen Effekt, der darauf zurückzuführen ist, wie sie trainiert werden. Dies zu erkennen, ist der erste Schritt, um emotionale Bestätigung nicht mit der Qualität einer Antwort zu verwechseln.
Alle Themen