Tag
Cómo funciona un LLM
Tokens, embeddings, atención: qué ocurre de verdad dentro de un modelo de lenguaje.
11 · Artículos sobre este tema
Los parámetros de un modelo: qué significan de verdad los miles de millones
Cada vez que sale un nuevo modelo de IA lo primero que se lee es un número: miles de millones de parámetros, como si fuera la cilindrada de un motor. Pero qué son de verdad estos parámetros y, sobre todo, ese número cuenta lo que parece contar? En este artículo vemos qué es un parámetro sin tecnicismos, por qué más grande no significa más acertado, qué cuenta de verdad más allá del tamaño de un modelo, y por qué la jugada sensata no es buscar el modelo más grande sino comparar perspectivas complementarias sobre el mismo problema, hasta el punto en que el hilo conduce a Arena.
Releer la respuesta antes de usarla: el último control sigue siendo humano
Un modelo de IA devuelve textos limpios, seguros, bien escritos — y es justo esa fluidez el punto más traicionero: una respuesta que suena bien parece ya lista, y la tentación de copiarla y pegarla sin releerla es fuerte. Pero la calidad de la forma no es la calidad del contenido. Releer antes de usar no es un trámite burocrático ni una señal de desconfianza hacia la herramienta: es el último control, el que sigue siendo humano, y cambia el modo en que una respuesta de la IA se convierte en tu decisión. En este artículo vemos por qué una respuesta convincente no es una respuesta verificada, qué mirar de verdad cuando relees, y por qué este gesto es un método y no una pérdida de tiempo — hasta el punto en que el hilo lleva a Arena.
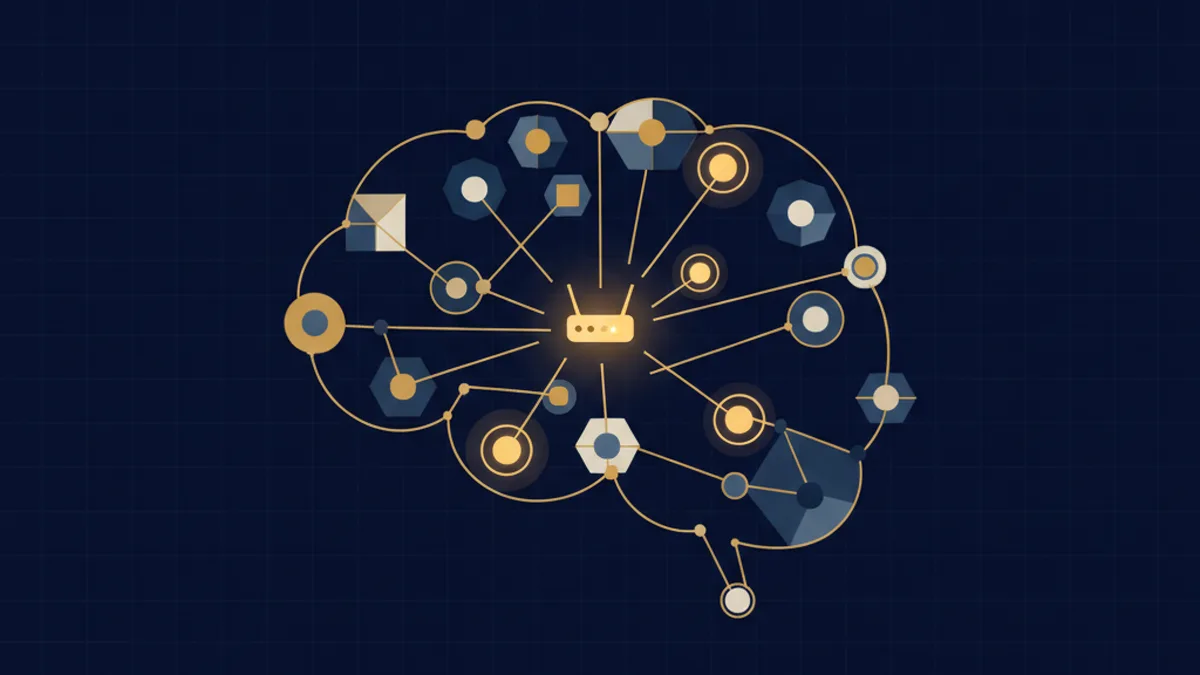
Mixture of Experts: cómo un modelo de IA activa solo los expertos adecuados
Durante años la intuición sobre los modelos de IA fue simple: cuanto más grande, más capaz. Pero hay un costo oculto, porque cada respuesta enciende el modelo entero incluso para la pregunta más trivial. El Mixture of Experts (una mezcla de expertos) rompe ese vínculo: divide el conocimiento en muchas subredes especializadas y activa solo algunas cada vez, elegidas por un enrutador interno. Así un modelo puede ser enorme en su saber total y ligero en lo que usa en cada respuesta. Pero sigue siendo un único modelo, con una sola visión del problema: el enrutador elige entre expertos que comparten el mismo entrenamiento. Para las decisiones que importan el límite no es la eficiencia, es la perspectiva única — y ese es el salto que lleva a Arena.
Búsqueda semántica: cómo una IA entiende el significado más allá de las palabras
Durante décadas buscar significó hacer coincidir palabras: escribes un término y el sistema encuentra los documentos que contienen ese mismo término. La búsqueda semántica cambia las reglas. No persigue las palabras, persigue el significado: entiende que una pregunta formulada de una manera y una respuesta escrita de otra pueden hablar de lo mismo aunque no compartan una sola palabra. Detrás de este salto hay una forma distinta de representar el lenguaje, que permite a una IA encontrar lo que quieres decir y no solo lo que tecleas. Comprender cómo funciona ayuda a leer mejor los sistemas que usamos cada día, y a entender por qué comparar varias perspectivas sigue siendo el paso que de verdad importa.
El prompt de sistema: qué guía de verdad a un modelo de IA
Cuando le escribes a un asistente de IA nunca partes de una página en blanco: antes de tu pregunta, el modelo ya ha recibido un conjunto de instrucciones que tú no ves. Se llama prompt de sistema, y es la capa que decide quién es el modelo, cómo escribe y qué puede hacer. Entenderlo explica por qué dos IA, ante la misma pregunta, te responden de forma tan distinta.
Tokenización: cómo un modelo de IA lee realmente el texto
Cuando lees una frase la divides en palabras sin darte cuenta, y sobre esos pedazos construyes el sentido. Un modelo de IA hace algo parecido antes incluso de entender nada, pero los pedazos en los que divide el texto no son nuestras palabras: son tokens, fragmentos que pueden valer una palabra entera o solo una parte de ella. Ese primer corte tiene un nombre, tokenización (tokenization), y es el gesto invisible del que depende todo lo que el modelo hará después: cuánto cuesta una respuesta, cuánto texto logra mantener junto, dónde tropieza. Entender cómo un modelo divide el texto ayuda a desmontar la idea de que lee como nosotros, y muestra por qué una única forma de cortar es también un único punto de vista. De ahí nace el valor de poner varias perspectivas frente a frente.
Atención: cómo un modelo de IA decide qué cuenta en una frase
Cuando lees una frase no le das el mismo peso a cada palabra: algunas las dejas pasar, en otras te detienes, y entiendes el sentido justo por cómo las conectas entre sí. Un modelo de IA hace algo parecido, y tiene un nombre preciso: atención (attention). Es el mecanismo que le permite, mientras procesa un texto, establecer qué palabras cuentan más para interpretar las demás, y sostener el significado en lugar de leer palabra por palabra de forma plana. Entender esta idea ayuda a deshacer un malentendido muy extendido, esto es, que el modelo lea como nosotros. No lee: pesa. Y la forma en que pesa las palabras es también su límite más profundo, porque es una sola manera de decidir qué cuenta. De ahí nace el valor de poner más perspectivas en contraste en lugar de fiarte de una sola lectura.
Embedding: cómo un modelo de IA organiza el significado
Cuando le escribes una frase a un sistema de IA, antes incluso de que responda ocurre algo invisible: tus palabras se transforman en números, en coordenadas dentro de un espacio. Ese paso tiene un nombre, embedding, y es uno de los ladrillos sobre los que se apoya casi todo lo que la IA sabe hacer hoy, desde la búsqueda por significado hasta la capacidad de conectar ideas lejanas. No es un detalle para especialistas: entender, a grandes rasgos, cómo un modelo coloca los conceptos en este espacio ayuda a comprender por qué ciertas cosas le salen muy bien y otras lo traicionan. El modelo no conoce el mundo como lo conoces tú, pero tiene un mapa del significado, y ese mapa explica mucho de su comportamiento. Vale la pena mirar dentro, sin tecnicismos, para usar la IA con más consciencia.
Temperatura: por qué la misma pregunta a la IA da respuestas distintas
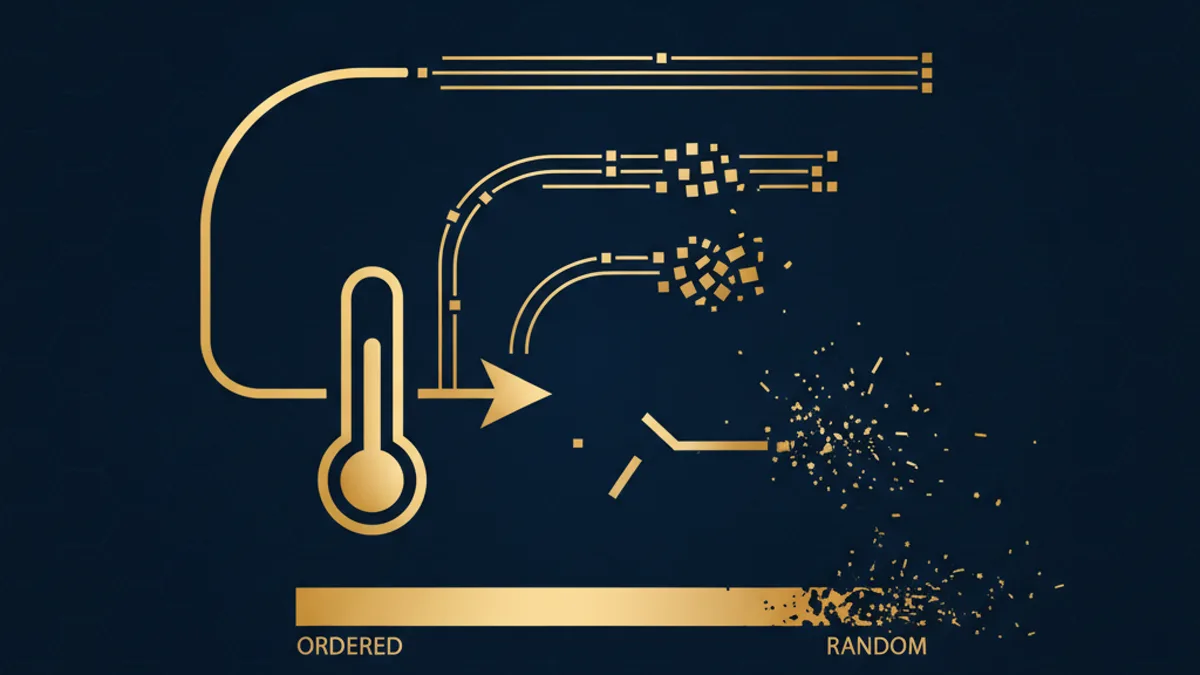
Haz la misma pregunta a un sistema de IA dos veces y puedes recibir dos respuestas diferentes. No es un error ni un capricho: es una decisión de diseño, gobernada por un parámetro llamado temperatura. La temperatura regula cuánta libertad se concede el modelo al elegir la palabra siguiente: baja y las respuestas se vuelven previsibles y repetibles, alta y se vuelven variadas y creativas pero menos estables. Entender este parámetro explica de golpe muchas cosas que parecen extrañas: por qué un modelo a veces inventa, por qué dos intentos no coinciden, por qué la misma petición rinde mejor en un momento y peor en otro. No es un detalle para técnicos: es la razón por la que no puedes juzgar un sistema de IA por una sola respuesta, y por la que comparar varias perspectivas vale más que el intento afortunado aislado.
Cuando las IA no coinciden: el desacuerdo es una señal
Cuando varios modelos de IA divergen sobre el mismo problema, la divergencia no es un defecto que haya que limar: es una información de que el terreno es incierto o disputado. Quien se apoya en una sola IA pierde esta señal. Quien compara perspectivas complementarias convierte el desacuerdo en decisiones más informadas y menos frágiles.
Adulación: por qué los modelos generativos tienden a complacer al usuario
La «sycophancy», es decir, la tendencia de los modelos de IA a complacer al usuario, no es un defecto moral. Es un efecto estructural derivado de cómo se entrenan. Reconocerlo es el primer paso para no confundir el refuerzo emocional con la calidad de una respuesta.
Todos los temas