Mixture of Experts: cómo un modelo de IA activa solo los expertos adecuados
Durante años la intuición sobre los modelos de IA fue simple: cuanto más grande, más capaz. Pero hay un costo oculto, porque cada respuesta enciende el modelo entero incluso para la pregunta más trivial. El Mixture of Experts (una mezcla de expertos) rompe ese vínculo: divide el conocimiento en muchas subredes especializadas y activa solo algunas cada vez, elegidas por un enrutador interno. Así un modelo puede ser enorme en su saber total y ligero en lo que usa en cada respuesta. Pero sigue siendo un único modelo, con una sola visión del problema: el enrutador elige entre expertos que comparten el mismo entrenamiento. Para las decisiones que importan el límite no es la eficiencia, es la perspectiva única — y ese es el salto que lleva a Arena.
por Redazione AI Arena
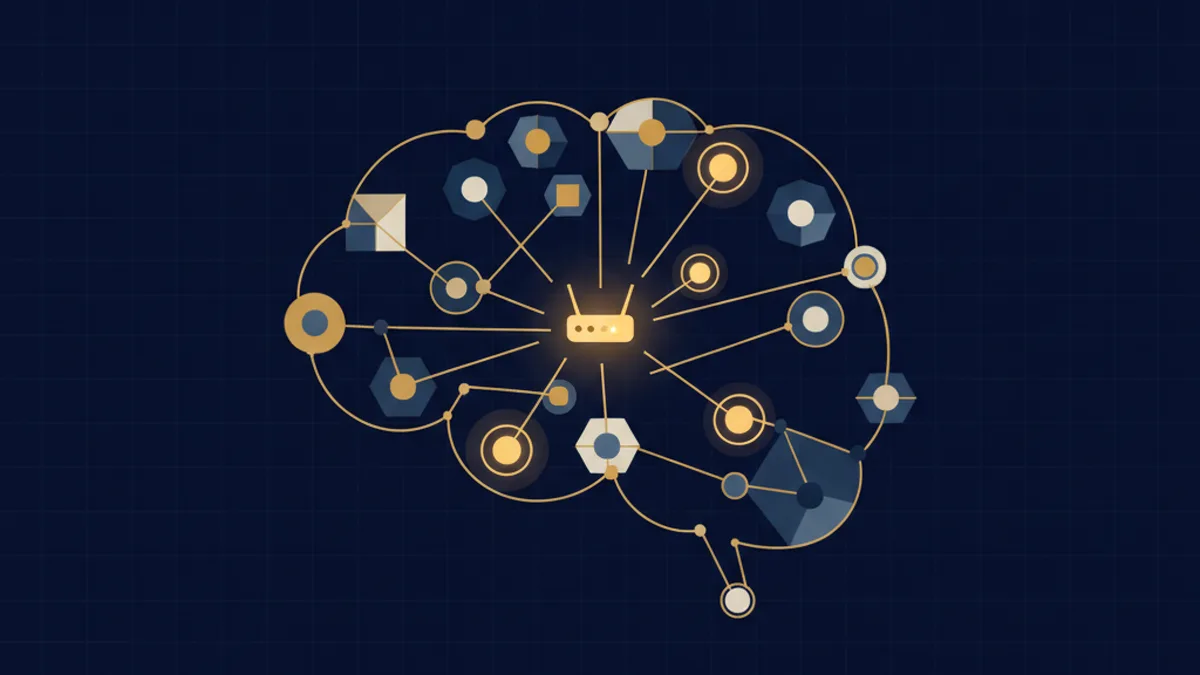
Durante años la intuición dominante sobre los modelos de IA fue simple: cuanto más grande, más capaz. Aumentas los parámetros y el modelo sabe hacer más. Pero dentro de esa carrera hacia el tamaño se esconde un costo que rara vez se cuenta: cada vez que el modelo responde usa todo lo que es, cada parámetro, incluso para la pregunta más trivial. Es como encender una fábrica entera para apretar un tornillo. El Mixture of Experts, a menudo abreviado como MoE, nace justamente para romper ese vínculo entre tamaño y costo — un modelo puede ser enorme en su saber total y ligero en lo que activa de verdad en cada respuesta.
Un modelo que no se usa entero cada vez
La idea de fondo del Mixture of Experts (una mezcla de expertos) es dividir el conocimiento del modelo en muchas subredes especializadas, los expertos, y poner a trabajar solo las que hacen falta para una solicitud dada. No es un conjunto de modelos separados: es un único modelo dentro del cual conviven muchos bloques, cada uno vuelto bueno en una porción del trabajo durante el entrenamiento. Uno puede haberse sintonizado con el código, otro con cierto tipo de razonamiento, otro más con un matiz particular del lenguaje — aunque en la práctica estas especializaciones son más difusas y menos legibles de lo que las contamos con palabras.
Cuando llega una solicitud, el modelo no llama a todos los expertos. Selecciona un pequeño subconjunto, los más pertinentes, y deja apagados a los demás. El resultado es que un modelo con una capacidad total enorme, en la respuesta concreta, pone en juego solo una fracción. El conocimiento total sigue siendo grande; la cuenta a pagar en cada pregunta sigue siendo pequeña. Es esa la jugada que hace al MoE tan interesante: desacopla cuánto sabe un modelo de cuánto cuesta usarlo.
El enrutador que decide quién trabaja
La pieza que sostiene todo es el enrutador, a veces llamado gating: un pequeño mecanismo interno que, para cada fragmento de texto de entrada, decide a qué expertos pasarlo. No es una regla escrita a mano por un ingeniero, es algo que el modelo aprendió junto con el resto durante el entrenamiento. Con el tiempo el enrutador entiende que cierto tipo de entrada rinde mejor si se encamina hacia ciertos expertos, y afina esa elección en cada paso.
Ese encaminamiento es la parte más delicada de la arquitectura. Si el enrutador manda casi todo siempre a los mismos dos o tres expertos, los demás quedan inútiles y la capacidad extra se desperdicia; si reparte al azar, pierde la ventaja de la especialización. Por eso entrenar un MoE exige recursos que mantengan la carga equilibrada, de modo que todos los expertos se usen y ninguno se convierta en un cuello de botella. Vale la pena detenerse en un punto, porque es el que de verdad cuenta más adelante: incluso cuando el encaminamiento funciona a la perfección, sigue habiendo un solo modelo decidiendo cómo leer el problema. El enrutador elige entre expertos que comparten el mismo entrenamiento y la misma visión del mundo. Es eficiencia interna, no pluralidad de perspectivas.
Potencia sin pagar la cuenta entera
El motivo por el que el Mixture of Experts se ha vuelto central en los modelos más recientes es práctico antes que teórico. Permite hacer crecer el saber total de un sistema — más expertos, más competencias cubiertas — sin hacer crecer en proporción el costo y la lentitud de cada respuesta. Es una forma de sortear el compromiso entre calidad y velocidad que de otro modo obligaría a elegir: o un modelo grande y lento, o uno pequeño y rápido. Con el MoE se intenta tener ambas cosas, amplitud de competencia y ligereza en la respuesta concreta.
De ahí emerge un cambio más amplio en la dirección de la IA. Durante años se persiguió el tamaño como única palanca; hoy la investigación se desplaza hacia cómo organizar ese tamaño — qué partes activar, cuándo, con qué criterio. El MoE es una de las primeras señales de esa madurez: no basta un cerebro más grande, hace falta un cerebro que sepa usar la parte adecuada de sí mismo en el momento adecuado. Es un principio que se parece a cómo funcionan los sistemas complejos en general, donde la inteligencia no está solo en cada componente, sino sobre todo en el modo en que se coordinan.
Hacia dónde va el mundo, y Arena como conclusión natural
El Mixture of Experts resuelve un problema de eficiencia dentro de un único modelo: cómo dar mucha competencia sin pagarla por entero en cada respuesta. Pero se queda, precisamente, dentro de un modelo — un solo entrenamiento, un solo planteamiento, una sola idea de qué cuenta en un problema. Los expertos que el enrutador selecciona son variaciones de la misma mente, no puntos de vista distintos. Para muchas solicitudes eso basta y sobra. Para las decisiones que importan, no: ahí el límite no es la eficiencia, es la perspectiva única.
Y es exactamente el salto que lleva a Arena. AI Arena es la plataforma que pone a comparar varias identidades de IA con perspectivas distintas sobre el mismo problema, te hace seleccionar las respuestas más útiles y usa un Orchestrator para llevarte al paso siguiente, no sustituye tu decisión, te la hace tomar con más conciencia. Si el MoE elige expertos dentro de una sola cabeza, Arena pone a comparar cabezas distintas: eliges el equipo, traes tu pregunta, y 7 especialistas complementarios escriben cada uno su propia lectura, con perspectivas complementarias que un solo modelo — por bien encaminado que esté — no puede tener por sí mismo. Tú seleccionas lo que se sostiene, el sistema afina y profundiza, y el Orchestrator, el meta-layer que mantiene unido el flujo, te acompaña hasta el informe final. La eficiencia interna de un modelo es una cosa; la comparación entre visiones distintas es otra, y para las decisiones que pesan es la que marca la diferencia.
Únete a Arena.
FAQ
Qué es el Mixture of Experts en un modelo de IA?
El Mixture of Experts, a menudo abreviado como MoE, es una mezcla de expertos: una forma de construir un modelo de IA dividiendo su conocimiento en muchas subredes especializadas, llamadas expertos, en lugar de mantenerlo en un único bloque indiferenciado. No se trata de modelos separados unidos entre sí, sino de un solo modelo dentro del cual conviven muchos expertos, cada uno vuelto bueno en una porción del trabajo durante el entrenamiento. La característica clave es que, para cada solicitud, el modelo activa solo un pequeño subconjunto de expertos y deja apagados a los demás. Así el conocimiento total puede ser enorme, mientras que lo que el modelo usa de verdad en cada respuesta sigue siendo una fracción.
Cómo elige un modelo MoE qué expertos usar?
La tarea recae en un componente interno llamado enrutador, o gating. Para cada fragmento de texto de entrada, el enrutador decide a qué expertos pasarlo, encaminando la solicitud hacia los más pertinentes. No es una regla escrita a mano: es algo que el modelo aprendió durante el entrenamiento, junto con el resto. Con el tiempo el enrutador entiende que ciertos tipos de entrada rinden mejor si se envían a ciertos expertos. Es la parte más delicada de la arquitectura, porque si encaminara todo siempre a los mismos la capacidad extra se desperdiciaría, y si repartiera al azar perdería la ventaja de la especialización.
Por qué el Mixture of Experts hace un modelo más eficiente?
Porque separa el tamaño total del modelo del costo de cada respuesta. En un modelo tradicional cada parámetro se usa en cada solicitud, así que hacer crecer el saber significa hacer crecer en proporción también el costo y la lentitud. Con el MoE se pueden añadir expertos, y por tanto competencias, sin activarlos todos a la vez: en cada respuesta trabaja solo la parte seleccionada. Es una forma de sortear el compromiso entre calidad y velocidad, que de otro modo obligaría a elegir entre un modelo grande y lento o uno pequeño y rápido.
Un modelo Mixture of Experts es como usar varios modelos de IA juntos?
No, y es una distinción importante. En un MoE los expertos son partes de un único modelo, nacidas del mismo entrenamiento y con el mismo planteamiento de fondo: el enrutador elige entre variaciones de la misma mente, no entre puntos de vista distintos. Es eficiencia interna, no pluralidad de perspectivas. Usar varias IA distintas juntas es otra cosa: significa poner a comparar identidades distintas, entrenadas y configuradas de forma diferente, que leen el mismo problema desde ángulos de verdad distintos. El MoE optimiza cómo un solo modelo se usa a sí mismo, la comparación entre varias IA añade la variedad de visiones que un solo modelo no puede tener.
Cómo se conecta el Mixture of Experts con la comparación entre varias IA de Arena?
AI Arena es la plataforma que pone a comparar varias identidades de IA con perspectivas distintas sobre el mismo problema, te hace seleccionar las respuestas más útiles y usa un Orchestrator para llevarte al paso siguiente, no sustituye tu decisión, te la hace tomar con más conciencia. El MoE resuelve un problema de eficiencia dentro de una sola mente, eligiendo qué expertos activar, pero sigue siendo una perspectiva única. Arena trabaja en el nivel de encima: eliges el equipo y 7 especialistas complementarios escriben cada uno su propia lectura, con perspectivas complementarias que un solo modelo no puede tener. Tú seleccionas lo que se sostiene, el sistema afina y profundiza, y el Orchestrator mantiene unido el flujo hasta el informe final.
Temas