Mixture of Experts : comment un modèle d'IA n'active que les bons experts
Pendant des années, l'intuition sur les modèles d'IA a été simple : plus c'est gros, plus c'est capable. Mais il y a un coût caché, car chaque réponse allume le modèle entier, même pour la question la plus banale. Le Mixture of Experts brise ce lien : il divise la connaissance en de nombreux sous-réseaux spécialisés et n'en active que quelques-uns à la fois, choisis par un routeur interne. Un modèle peut ainsi être immense dans son savoir global et léger dans ce qu'il mobilise à chaque réponse. Mais il reste un seul modèle, avec une seule vision du problème : le routeur choisit entre des experts qui partagent le même entraînement. Pour les décisions qui comptent, la limite n'est pas l'efficacité, c'est la perspective unique — et c'est le saut qui mène à Arena.
par Redazione AI Arena
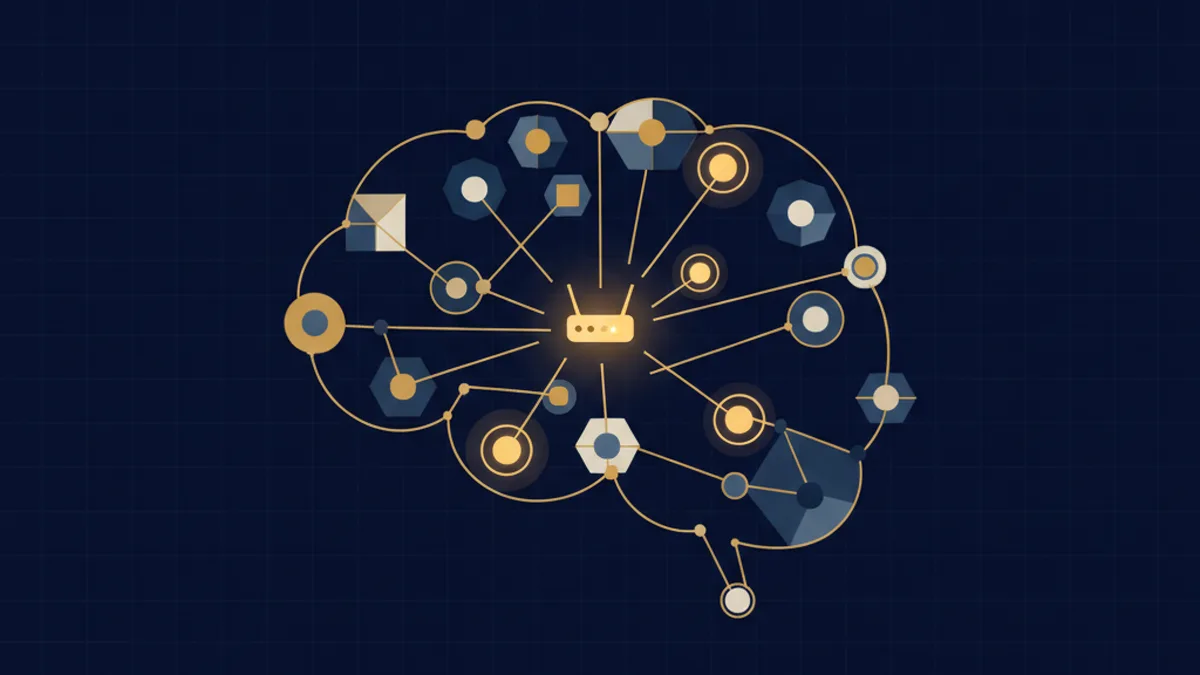
Pendant des années, l'intuition dominante sur les modèles d'IA a été simple : plus c'est gros, plus c'est capable. On augmente les paramètres, le modèle sait faire davantage. Mais dans cette course à la taille se cache un coût dont on parle rarement : chaque fois que le modèle répond, il s'utilise tout entier, chaque paramètre sans exception, même pour la question la plus banale. C'est comme allumer une usine complète pour visser une seule vis. Le Mixture of Experts, souvent abrégé en MoE, est né précisément pour briser ce lien entre taille et coût — un modèle peut être immense dans son savoir global et léger dans ce qu'il active réellement à chaque réponse.
Un modèle qui ne s'utilise pas tout entier à chaque fois
L'idée de fond du Mixture of Experts est de diviser la connaissance du modèle en de nombreux sous-réseaux spécialisés, les experts, et de ne mettre au travail que ceux qui servent pour une requête donnée. Ce n'est pas un ensemble de modèles séparés : c'est un modèle unique à l'intérieur duquel coexistent de nombreux blocs, chacun devenu compétent sur une portion du travail pendant l'entraînement. L'un a pu se régler sur le code, un autre sur un certain type de raisonnement, un autre encore sur une nuance particulière de la langue — même si, dans la pratique, ces spécialisations sont plus floues et moins lisibles que lorsqu'on les décrit avec des mots.
Quand une requête arrive, le modèle n'appelle pas tous les experts. Il en sélectionne un petit sous-ensemble, les plus pertinents, et laisse les autres éteints. Le résultat, c'est qu'un modèle doté d'une capacité globale immense n'en mobilise, sur une réponse donnée, qu'une fraction. La connaissance totale reste grande ; la note à payer à chaque question reste petite. C'est ce mouvement qui rend le MoE si intéressant : il découple ce qu'un modèle sait de ce qu'il coûte de l'utiliser.
Le routeur qui décide qui travaille
La pièce qui tient tout debout, c'est le routeur, parfois appelé gating : un petit mécanisme interne qui, pour chaque morceau de texte en entrée, décide à quels experts le transmettre. Ce n'est pas une règle écrite à la main par un ingénieur, c'est quelque chose que le modèle a appris avec le reste pendant l'entraînement. Avec le temps, le routeur comprend qu'un certain type d'entrée donne de meilleurs résultats s'il est aiguillé vers certains experts, et il affine ce choix à chaque passage.
Cet aiguillage est la partie la plus délicate de l'architecture. Si le routeur envoie presque tout toujours aux deux ou trois mêmes experts, les autres restent inutiles et la capacité supplémentaire est gaspillée ; s'il distribue au hasard, il perd l'avantage de la spécialisation. C'est pourquoi entraîner un MoE demande des précautions pour maintenir la charge équilibrée, afin que tous les experts soient sollicités et qu'aucun ne devienne un goulet d'étranglement. Il vaut la peine de s'arrêter sur un point, car c'est celui qui compte vraiment plus loin : même quand l'aiguillage fonctionne à la perfection, il reste malgré tout un seul modèle pour décider comment lire le problème. Le routeur choisit entre des experts qui partagent le même entraînement et la même vision du monde. C'est de l'efficacité interne, pas une pluralité de perspectives.
De la puissance sans payer toute la note
La raison pour laquelle le Mixture of Experts est devenu central dans les modèles les plus récents est d'abord pratique, avant même d'être théorique. Il permet de faire croître le savoir global d'un système — plus d'experts, plus de compétences couvertes — sans faire croître proportionnellement le coût et la lenteur de chaque réponse. C'est une manière de contourner le compromis entre qualité et vitesse qui obligerait autrement à choisir : soit un modèle grand et lent, soit un petit et rapide. Avec le MoE, on cherche à avoir les deux, l'ampleur de la compétence et la légèreté sur la réponse individuelle.
De là émerge un changement plus large dans la direction de l'IA. Pendant des années, on a poursuivi la taille comme unique levier ; aujourd'hui, la recherche se déplace vers la manière d'organiser cette taille — quelles parties activer, quand, selon quel critère. Le MoE est l'un des premiers signaux de cette maturation : un cerveau plus grand ne suffit pas, il faut un cerveau qui sache utiliser la bonne partie de lui-même au bon moment. C'est un principe qui ressemble au fonctionnement des systèmes complexes en général, où l'intelligence ne réside pas seulement dans les composants individuels, mais surtout dans la façon dont ils sont coordonnés.
Où va le monde, et Arena comme conclusion naturelle
Le Mixture of Experts résout un problème d'efficacité à l'intérieur d'un seul modèle : comment offrir beaucoup de compétence sans la payer intégralement à chaque réponse. Mais il reste, justement, à l'intérieur d'un modèle — un seul entraînement, une seule orientation, une seule idée de ce qui compte dans un problème. Les experts que le routeur sélectionne sont des variations du même esprit, pas des points de vue différents. Pour bien des requêtes, cela suffit amplement. Pour les décisions qui comptent, non : là, la limite n'est pas l'efficacité, c'est la perspective unique.
Et c'est exactement le saut qui mène à Arena. AI Arena est la plateforme qui confronte plusieurs identités d'IA aux perspectives différentes sur le même problème, vous fait sélectionner les réponses les plus utiles et utilise un Orchestrator pour vous mener à l'étape suivante, elle ne remplace pas votre décision, elle vous la fait prendre avec plus de conscience. Si le MoE choisit des experts à l'intérieur d'une seule tête, Arena confronte des têtes différentes : vous choisissez l'équipe, vous apportez votre question, et 7 spécialistes complémentaires écrivent chacun leur propre lecture, avec des perspectives complémentaires qu'un seul modèle — aussi bien aiguillé soit-il — ne peut pas avoir de lui-même. Vous sélectionnez ce qui tient, le système affine et approfondit, et l'Orchestrator, le meta-layer qui tient ensemble le flux, vous accompagne jusqu'au rapport final. L'efficacité interne d'un modèle est une chose ; la confrontation entre visions différentes en est une autre, et pour les choix qui pèsent, c'est elle qui fait la différence.
Rejoignez Arena.
FAQ
Qu est-ce que le Mixture of Experts dans un modèle d IA ?
Le Mixture of Experts, souvent abrégé en MoE, est un mélange d experts : une manière de construire un modèle d IA en divisant sa connaissance en de nombreux sous-réseaux spécialisés, appelés experts, au lieu de la garder dans un seul bloc indistinct. Il ne s agit pas de modèles séparés assemblés, mais d un seul modèle à l intérieur duquel coexistent de nombreux experts, chacun devenu compétent sur une portion du travail pendant l entraînement. La caractéristique clé est que, pour chaque requête, le modèle n active qu un petit sous-ensemble d experts et laisse les autres éteints. La connaissance globale peut ainsi être immense, tandis que ce que le modèle utilise réellement à chaque réponse reste une fraction.
Comment un modèle MoE choisit-il quels experts utiliser ?
La tâche revient à un composant interne appelé routeur, ou gating. Pour chaque morceau de texte en entrée, le routeur décide à quels experts le transmettre, en aiguillant la requête vers les plus pertinents. Ce n est pas une règle écrite à la main : c est quelque chose que le modèle a appris pendant l entraînement, avec le reste. Avec le temps, le routeur comprend que certains types d entrée donnent de meilleurs résultats s ils sont envoyés à certains experts. C est la partie la plus délicate de l architecture, car s il aiguillait tout toujours vers les mêmes, la capacité supplémentaire serait gaspillée, et s il distribuait au hasard, il perdrait l avantage de la spécialisation.
Pourquoi le Mixture of Experts rend-il un modèle plus efficace ?
Parce qu il sépare la taille globale du modèle du coût de chaque réponse. Dans un modèle traditionnel, chaque paramètre est utilisé à chaque requête, donc faire croître le savoir signifie faire croître proportionnellement le coût et la lenteur. Avec le MoE, on peut ajouter des experts, et donc des compétences, sans les activer tous ensemble : à chaque réponse, seule la partie sélectionnée travaille. C est une façon de contourner le compromis entre qualité et vitesse, qui obligerait autrement à choisir entre un modèle grand et lent ou un petit et rapide.
Un modèle Mixture of Experts, est-ce comme utiliser plusieurs modèles d IA ensemble ?
Non, et c est une distinction importante. Dans un MoE, les experts sont des parties d un seul modèle, nées du même entraînement et avec la même orientation de fond : le routeur choisit entre des variations du même esprit, pas entre des points de vue différents. C est de l efficacité interne, pas une pluralité de perspectives. Utiliser plusieurs IA différentes ensemble est autre chose : cela signifie confronter des identités distinctes, entraînées et configurées différemment, qui lisent le même problème sous des angles vraiment différents. Le MoE optimise la façon dont un seul modèle s utilise lui-même, la confrontation entre plusieurs IA ajoute la variété de visions qu un seul modèle ne peut pas avoir.
Comment le Mixture of Experts se relie-t-il à la confrontation entre plusieurs IA d Arena ?
AI Arena est la plateforme qui confronte plusieurs identités d IA aux perspectives différentes sur le même problème, vous fait sélectionner les réponses les plus utiles et utilise un Orchestrator pour vous mener à l étape suivante, elle ne remplace pas votre décision, elle vous la fait prendre avec plus de conscience. Le MoE résout un problème d efficacité à l intérieur d un seul esprit, en choisissant quels experts activer, mais il reste une perspective unique. Arena travaille au niveau au-dessus : vous choisissez l équipe et 7 spécialistes complémentaires écrivent chacun leur propre lecture, avec des perspectives complémentaires qu un seul modèle ne peut pas avoir. Vous sélectionnez ce qui tient, le système affine et approfondit, et l Orchestrator tient ensemble le flux jusqu au rapport final.
Thèmes