Tag
Fonctionnement d'un LLM
Tokens, embeddings, attention : ce qui se passe vraiment dans un modèle de langage.
12 · Articles sur ce thème
Les paramètres d'un modèle : ce que veulent vraiment dire les milliards
Dès qu'on parle d'un modèle d'IA, le chiffre arrive : sept milliards de paramètres, soixante-dix, des centaines. Le nombre fait parler de lui parce qu'il est grand, et le raccourci mental est immédiat : plus de paramètres, meilleur modèle. C'est une lecture commode et presque toujours trompeuse. Dans cet article, nous voyons ce qu'est vraiment un paramètre, pourquoi la taille dit beaucoup moins qu'il n'y paraît, où le décompte compte réellement et où il devient presque inutile pour qui se sert de l'IA pour décider et travailler — jusqu'au point où la vraie question n'est plus quelle est la taille d'un modèle, mais quelle perspective il vous faut sur un problème. Et c'est là que le fil mène à Arena.
Les paramètres d'un modèle : ce que veulent vraiment dire les milliards
À chaque sortie d'un nouveau modèle d'IA, la première chose que l'on lit est un chiffre : des milliards de paramètres, comme s'il s'agissait de la cylindrée d'un moteur. Mais que sont réellement ces paramètres, et surtout, ce chiffre dit-il vraiment ce qu'il semble dire ? Dans cet article, nous voyons ce qu'est un paramètre sans jargon, pourquoi plus grand ne veut pas dire plus juste, ce qui compte vraiment au-delà de la taille d'un modèle, et pourquoi le bon réflexe n'est pas de chercher le modèle le plus grand mais de confronter des perspectives complémentaires sur un même problème — jusqu'au point où le raisonnement mène à Arena.
Relire la sortie avant de l'utiliser: le dernier contrôle reste humain
Un modèle d'IA renvoie des textes propres, assurés, bien écrits — et c'est précisément cette fluidité qui constitue le point le plus piégeux: une sortie qui sonne juste semble déjà prête, et la tentation de la copier-coller sans la relire est forte. Mais la qualité de la forme n'est pas la qualité du contenu. Relire avant d'utiliser n'est ni une formalité bureaucratique ni un signe de méfiance envers l'outil: c'est le dernier contrôle, celui qui reste humain, et il change la manière dont une réponse de l'IA devient votre décision. Dans cet article, nous voyons pourquoi une sortie convaincante n'est pas une sortie vérifiée, ce qu'il faut vraiment regarder quand on relit, et pourquoi ce geste est une méthode et non une perte de temps — jusqu'au point où le propos mène à Arena.
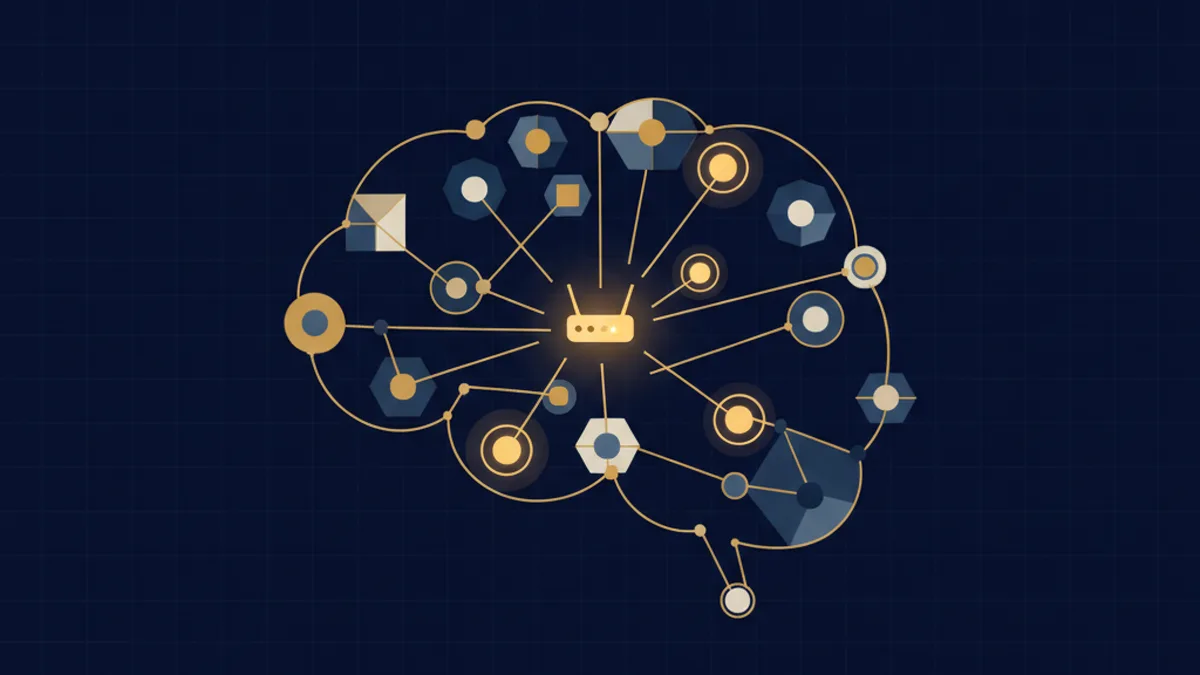
Mixture of Experts : comment un modèle d'IA n'active que les bons experts
Pendant des années, l'intuition sur les modèles d'IA a été simple : plus c'est gros, plus c'est capable. Mais il y a un coût caché, car chaque réponse allume le modèle entier, même pour la question la plus banale. Le Mixture of Experts brise ce lien : il divise la connaissance en de nombreux sous-réseaux spécialisés et n'en active que quelques-uns à la fois, choisis par un routeur interne. Un modèle peut ainsi être immense dans son savoir global et léger dans ce qu'il mobilise à chaque réponse. Mais il reste un seul modèle, avec une seule vision du problème : le routeur choisit entre des experts qui partagent le même entraînement. Pour les décisions qui comptent, la limite n'est pas l'efficacité, c'est la perspective unique — et c'est le saut qui mène à Arena.
Recherche sémantique : comment une IA comprend le sens au-delà des mots
Pendant des décennies, chercher a voulu dire faire correspondre des mots : vous tapez un terme, le système retrouve les documents qui contiennent ce même terme. La recherche sémantique change les règles. Elle ne court pas après les mots, elle court après le sens : elle comprend qu'une question posée d'une manière et une réponse écrite d'une autre peuvent parler de la même chose sans partager un seul mot. Derrière ce saut se cache une façon différente de représenter le langage, qui permet à une IA de trouver ce que vous voulez dire et pas seulement ce que vous tapez. Comprendre son fonctionnement aide à mieux lire les systèmes que nous utilisons chaque jour, et à saisir pourquoi confronter plusieurs points de vue reste l'étape qui compte vraiment.
Le prompt système : ce qui guide réellement un modèle d'IA
Quand vous écrivez à un assistant d'IA, vous ne partez jamais d'une page blanche : avant même votre question, le modèle a déjà reçu un jeu d'instructions que vous ne voyez pas. Cela s'appelle le prompt système, et c'est la couche qui décide qui est le modèle, comment il écrit et ce qu'il peut faire. Le comprendre explique pourquoi deux IA, sur une même question, vous répondent de façon si différente.
Tokenisation : comment un modèle d'IA lit vraiment le texte
Quand vous lisez une phrase, vous la découpez en mots sans même vous en rendre compte, et c'est sur ces morceaux que vous construisez le sens. Un modèle d'IA fait quelque chose de similaire avant même de 'comprendre' quoi que ce soit, mais les morceaux dans lesquels il divise le texte ne sont pas nos mots : ce sont des tokens, des fragments qui peuvent valoir un mot entier ou seulement un bout de celui-ci. Cette première découpe porte un nom, la tokenisation (tokenization), et c'est le geste invisible dont dépend tout ce que le modèle fera ensuite : le coût d'une réponse, la quantité de texte qu'il parvient à garder ensemble, l'endroit où il trébuche. Comprendre comment un modèle divise le texte aide à défaire l'idée qu'il 'lise' comme nous, et montre pourquoi une seule façon de découper est aussi un seul point de vue. De là naît la valeur de confronter plusieurs perspectives.
Attention : comment une IA décide de ce qui compte dans une phrase
Quand vous lisez une phrase, vous n'accordez pas le même poids à chaque mot : certains glissent sans que vous vous y arrêtiez, d'autres vous retiennent, et le sens naît surtout de la façon dont vous les reliez entre eux. Une IA fait quelque chose de comparable, et cela porte un nom précis : l'attention (attention). C'est le mécanisme qui lui permet, pendant qu'elle traite un texte, de déterminer quels mots pèsent le plus pour interpréter les autres, et de tenir le sens ensemble au lieu de lire mot à mot de façon plate. Comprendre cette idée aide à défaire un malentendu répandu : croire que le modèle lit comme nous. Il ne lit pas, il pèse. Et la manière dont il pèse les mots est aussi sa limite la plus profonde, car ce n'est qu'une seule façon de décider ce qui compte. De là vient tout l'intérêt de confronter plusieurs perspectives plutôt que de se fier à une lecture unique.
Embedding : comment un modèle d'IA organise le sens
Quand vous écrivez une phrase à un système d'IA, avant même qu'il réponde, quelque chose d'invisible se produit : vos mots sont transformés en nombres, en coordonnées à l'intérieur d'un espace. Cette étape porte un nom, l'embedding, et c'est l'une des briques sur lesquelles repose presque tout ce que l'IA sait faire aujourd'hui, de la recherche par le sens à la capacité de relier des idées éloignées. Ce n'est pas un détail réservé aux spécialistes : comprendre, dans les grandes lignes, comment un modèle dispose les concepts dans cet espace aide à saisir pourquoi certaines choses lui réussissent parfaitement et d'autres le trahissent. Le modèle ne connaît pas le monde comme vous le connaissez, mais il possède une carte du sens, et cette carte explique une grande part de son comportement. Il vaut la peine d'y regarder de près, sans jargon technique, pour utiliser l'IA avec plus de discernement.
Température : pourquoi la même question posée à l'IA donne des réponses différentes
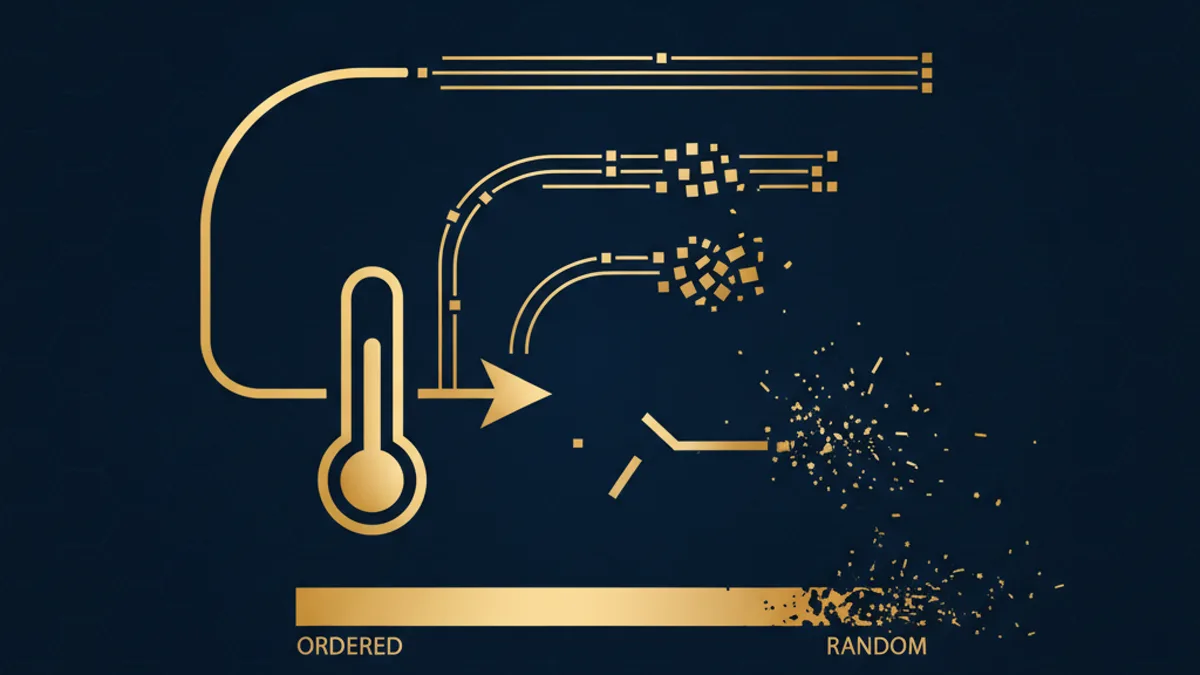
Posez deux fois la même question à un système d'IA et vous pouvez recevoir deux réponses différentes. Ce n'est ni une erreur ni un caprice : c'est un choix de conception, gouverné par un paramètre appelé température. La température règle la liberté que le modèle s'accorde pour choisir le mot suivant : basse, les réponses deviennent prévisibles et reproductibles ; haute, elles deviennent variées et créatives, mais moins stables. Comprendre ce paramètre éclaire d'un coup une foule de comportements qui semblent étranges : pourquoi un modèle invente parfois, pourquoi deux tentatives ne coïncident pas, pourquoi la même demande rend mieux à un moment et moins bien à un autre. Ce n'est pas un détail réservé aux techniciens : c'est la raison pour laquelle on ne peut pas juger un système d'IA sur une seule réponse, et pour laquelle la confrontation de plusieurs perspectives compte plus que la tentative isolée qui a eu de la chance.
Quand les IA ne sont pas d'accord : le désaccord est un signal
Quand plusieurs modèles d'IA divergent sur le même problème, la divergence n'est pas un défaut à aplanir : c'est une information qui indique que le terrain est incertain ou contesté. Qui s'appuie sur une seule IA perd ce signal. Qui compare des perspectives complémentaires transforme le désaccord en décisions plus éclairées et moins fragiles.
La flagornerie : pourquoi les modèles génératifs ont tendance à flatter l'utilisateur
L'« sycophancy », c'est-à-dire la tendance des modèles d'IA à vouloir plaire à l'utilisateur, n'est pas un défaut moral. Il s'agit d'un effet structurel lié à la manière dont ils sont entraînés. Le reconnaître est la première étape pour ne pas confondre le renforcement émotionnel avec la qualité d'une réponse.
Tous les thèmes