Sección
#Tecnologia
Cómo están hechos los sistemas de IA: arquitecturas, modelos, orquestación y los patrones que van surgiendo.
36 · Artículos de esta sección
Los parámetros de un modelo: qué significan de verdad los miles de millones
Cuando se habla de un modelo de IA siempre aparece la cifra: siete mil millones de parámetros, setenta, cientos. El número llama la atención porque es enorme, y el atajo mental es inmediato: más parámetros, mejor modelo. Es una lectura cómoda y casi siempre engañosa. En este artículo vemos qué es realmente un parámetro, por qué el tamaño dice mucho menos de lo que parece, dónde el conteo importa de verdad y dónde en cambio es casi inútil para quien usa la IA para decidir y trabajar, hasta el punto en que la pregunta que cuenta ya no es cómo de grande es un modelo, sino qué perspectiva necesitas sobre un problema, y es ahí donde el hilo lleva a Arena.
Los parámetros de un modelo: qué significan de verdad los miles de millones
Cada vez que sale un nuevo modelo de IA lo primero que se lee es un número: miles de millones de parámetros, como si fuera la cilindrada de un motor. Pero qué son de verdad estos parámetros y, sobre todo, ese número cuenta lo que parece contar? En este artículo vemos qué es un parámetro sin tecnicismos, por qué más grande no significa más acertado, qué cuenta de verdad más allá del tamaño de un modelo, y por qué la jugada sensata no es buscar el modelo más grande sino comparar perspectivas complementarias sobre el mismo problema, hasta el punto en que el hilo conduce a Arena.
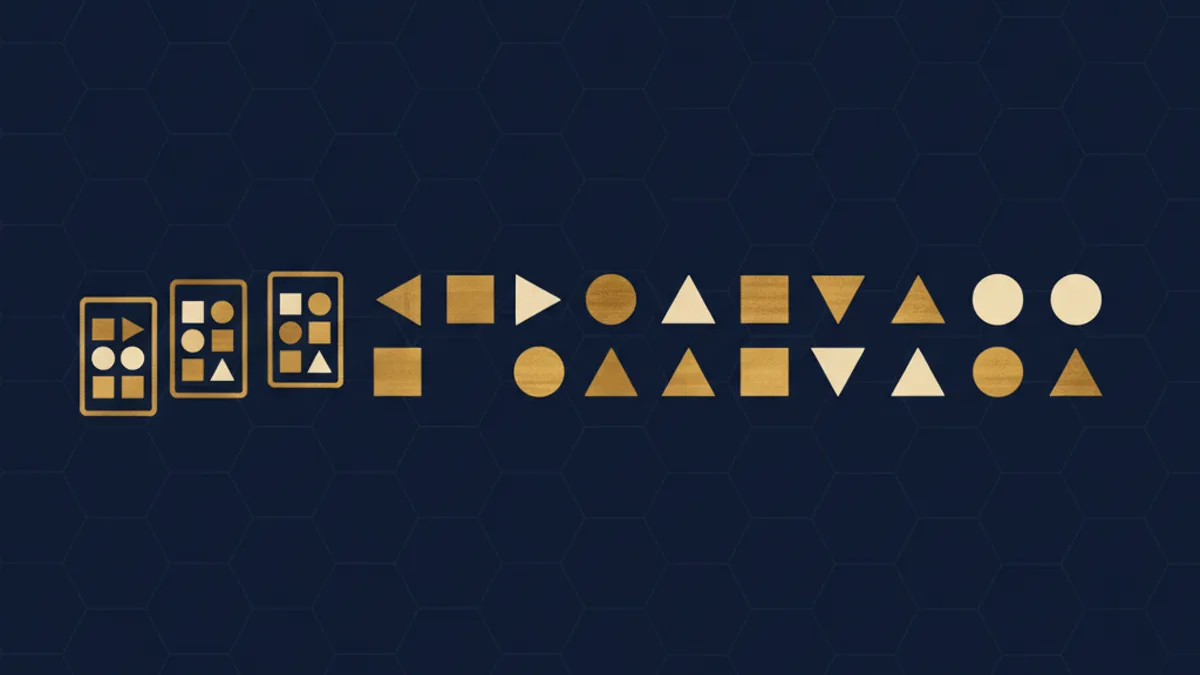
Few-shot: como unos pocos ejemplos guian la respuesta de un modelo de IA
Hay una forma sencilla de hacer que un modelo de IA entienda lo que quieres de verdad, y no pasa por instrucciones mas largas: pasa por un par de ejemplos. Mostrarle al modelo dos o tres casos de lo que consideras bien hecho — el par pregunta-respuesta, el formato, el tono — lo orienta mucho mas que cualquier descripcion con palabras. Esta tecnica se llama few-shot: pocos ejemplos dentro de la peticion que guian lo que el modelo escribe despues. Es una de las palancas mas practicas para trabajar bien con la IA, y explica por que a veces el mismo modelo pasa de respuestas genericas a respuestas certeras sin cambiar una linea de instrucciones. Pero tiene un limite que ningun ejemplo resuelve por si solo, y ahi es donde el tema conduce a Arena.
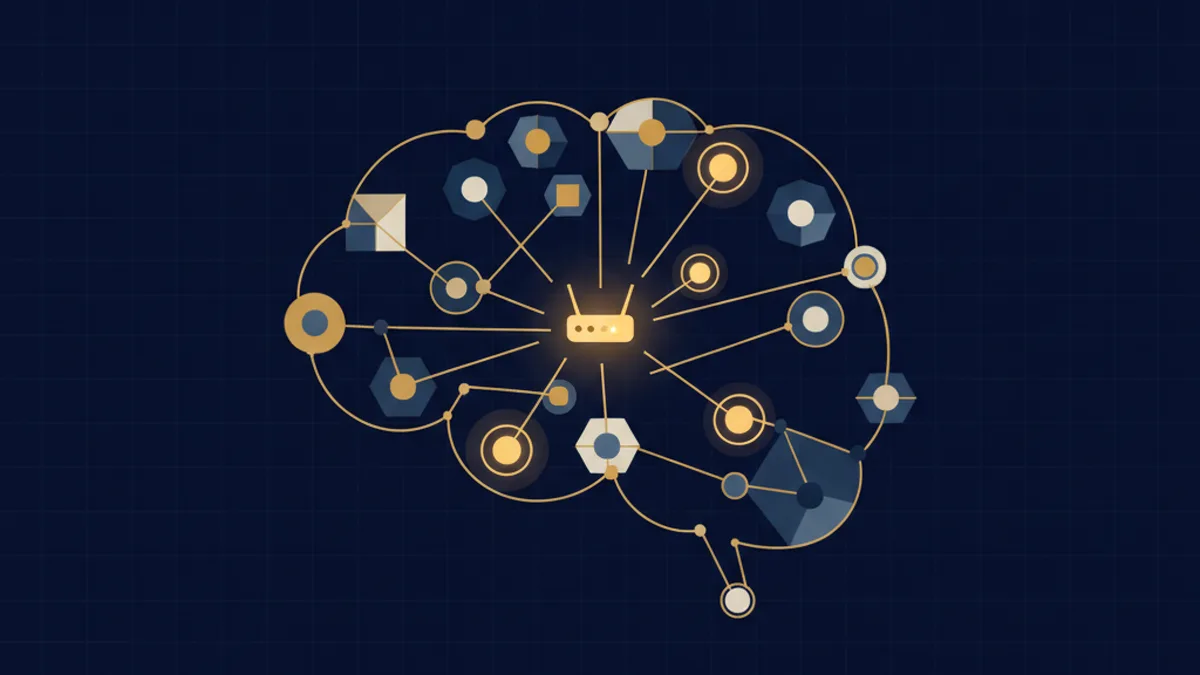
Mixture of Experts: cómo un modelo de IA activa solo los expertos adecuados
Durante años la intuición sobre los modelos de IA fue simple: cuanto más grande, más capaz. Pero hay un costo oculto, porque cada respuesta enciende el modelo entero incluso para la pregunta más trivial. El Mixture of Experts (una mezcla de expertos) rompe ese vínculo: divide el conocimiento en muchas subredes especializadas y activa solo algunas cada vez, elegidas por un enrutador interno. Así un modelo puede ser enorme en su saber total y ligero en lo que usa en cada respuesta. Pero sigue siendo un único modelo, con una sola visión del problema: el enrutador elige entre expertos que comparten el mismo entrenamiento. Para las decisiones que importan el límite no es la eficiencia, es la perspectiva única — y ese es el salto que lleva a Arena.
Pipeline multi-step: cómo varios pasos de IA se combinan en un flujo
Cuando pensamos en la IA solemos imaginar un solo gesto: una pregunta, una respuesta. Pero los sistemas que hacen un trabajo real rara vez funcionan así: detrás de una respuesta útil casi siempre hay una secuencia de pasos, cada uno de los cuales toma el resultado del anterior y lo lleva más lejos. Se llama pipeline multi-step (flujo de varios pasos) y es la forma en que una tarea compleja se descompone, se aborda pieza a pieza y se recompone en algo sólido. Entender cómo se arma un flujo ayuda a comprender por qué algunos sistemas de IA dan resultados fiables y otros no, y dónde la comparación entre varias perspectivas complementarias hace cada paso más robusto.
Búsqueda semántica: cómo una IA entiende el significado más allá de las palabras
Durante décadas buscar significó hacer coincidir palabras: escribes un término y el sistema encuentra los documentos que contienen ese mismo término. La búsqueda semántica cambia las reglas. No persigue las palabras, persigue el significado: entiende que una pregunta formulada de una manera y una respuesta escrita de otra pueden hablar de lo mismo aunque no compartan una sola palabra. Detrás de este salto hay una forma distinta de representar el lenguaje, que permite a una IA encontrar lo que quieres decir y no solo lo que tecleas. Comprender cómo funciona ayuda a leer mejor los sistemas que usamos cada día, y a entender por qué comparar varias perspectivas sigue siendo el paso que de verdad importa.
Fine-tuning: cómo se adapta un modelo de IA a un dominio concreto
Un modelo de lenguaje nace generalista: sabe un poco de todo, pero no conoce tu sector, tu lenguaje ni tus reglas. El fine-tuning es la técnica con la que se reentrena un modelo ya existente sobre ejemplos específicos, para volverlo más competente y más coherente en un dominio concreto. Entender qué es, cuándo conviene de verdad y qué lo distingue de simplemente dar más contexto es la manera de no esperar de esta técnica lo que no puede dar, y de comprender por qué incluso un modelo especializado gana cuando se pone a confrontar con perspectivas distintas.
Incertidumbre: cómo una IA señala (u oculta) cuando no sabe
Un asistente de IA responde siempre, incluso cuando no sabe: no está construido para decir no lo sé, sino para producir de todos modos un texto fluido y seguro. La incertidumbre existe, pero queda oculta bajo un tono uniforme que no distingue una respuesta sólida de una inventada. Entender cómo un modelo señala (u oculta) lo que no sabe, qué son la confianza y la calibración, y por qué comparar varias perspectivas complementarias hace que esa incertidumbre por fin se vuelva legible.
El prompt de sistema: qué guía de verdad a un modelo de IA
Cuando le escribes a un asistente de IA nunca partes de una página en blanco: antes de tu pregunta, el modelo ya ha recibido un conjunto de instrucciones que tú no ves. Se llama prompt de sistema, y es la capa que decide quién es el modelo, cómo escribe y qué puede hacer. Entenderlo explica por qué dos IA, ante la misma pregunta, te responden de forma tan distinta.
Destilación: cómo nace un modelo de IA más pequeño y rápido
Detrás de un asistente de IA que responde al instante en el móvil suele estar la destilación: la técnica que transfiere lo que sabe un modelo grande a uno más pequeño y ligero. Cómo funciona, qué se gana y qué se deja por el camino, y por qué habla de un mundo hecho de muchos modelos, no de uno solo.
Tokenización: cómo un modelo de IA lee realmente el texto
Cuando lees una frase la divides en palabras sin darte cuenta, y sobre esos pedazos construyes el sentido. Un modelo de IA hace algo parecido antes incluso de entender nada, pero los pedazos en los que divide el texto no son nuestras palabras: son tokens, fragmentos que pueden valer una palabra entera o solo una parte de ella. Ese primer corte tiene un nombre, tokenización (tokenization), y es el gesto invisible del que depende todo lo que el modelo hará después: cuánto cuesta una respuesta, cuánto texto logra mantener junto, dónde tropieza. Entender cómo un modelo divide el texto ayuda a desmontar la idea de que lee como nosotros, y muestra por qué una única forma de cortar es también un único punto de vista. De ahí nace el valor de poner varias perspectivas frente a frente.
Atención: cómo un modelo de IA decide qué cuenta en una frase
Cuando lees una frase no le das el mismo peso a cada palabra: algunas las dejas pasar, en otras te detienes, y entiendes el sentido justo por cómo las conectas entre sí. Un modelo de IA hace algo parecido, y tiene un nombre preciso: atención (attention). Es el mecanismo que le permite, mientras procesa un texto, establecer qué palabras cuentan más para interpretar las demás, y sostener el significado en lugar de leer palabra por palabra de forma plana. Entender esta idea ayuda a deshacer un malentendido muy extendido, esto es, que el modelo lea como nosotros. No lee: pesa. Y la forma en que pesa las palabras es también su límite más profundo, porque es una sola manera de decidir qué cuenta. De ahí nace el valor de poner más perspectivas en contraste en lugar de fiarte de una sola lectura.
Ensemble: varios modelos de IA para una respuesta más sólida
Preguntar a un solo modelo significa confiar en una única forma de ver el problema: si esa perspectiva tiene un punto ciego, lo heredas entero. La idea de ensemble, que en el mundo de los sistemas de IA quiere decir combinar varios modelos en lugar de elegir uno solo, nace precisamente por eso: una respuesta construida sobre varias perspectivas complementarias es casi siempre más robusta que una respuesta única, porque los errores aislados de un modelo quedan al descubierto gracias a los demás. No es un promedio que aplana, sino un contraste que revela dónde varias visiones convergen, y por tanto se sostienen, y dónde divergen, y por tanto merecen atención. Es el paso de la respuesta de una IA a la respuesta más sólida que varias IA, puestas en contraste, consiguen mostrarte.
Embedding: cómo un modelo de IA organiza el significado
Cuando le escribes una frase a un sistema de IA, antes incluso de que responda ocurre algo invisible: tus palabras se transforman en números, en coordenadas dentro de un espacio. Ese paso tiene un nombre, embedding, y es uno de los ladrillos sobre los que se apoya casi todo lo que la IA sabe hacer hoy, desde la búsqueda por significado hasta la capacidad de conectar ideas lejanas. No es un detalle para especialistas: entender, a grandes rasgos, cómo un modelo coloca los conceptos en este espacio ayuda a comprender por qué ciertas cosas le salen muy bien y otras lo traicionan. El modelo no conoce el mundo como lo conoces tú, pero tiene un mapa del significado, y ese mapa explica mucho de su comportamiento. Vale la pena mirar dentro, sin tecnicismos, para usar la IA con más consciencia.
Temperatura: por qué la misma pregunta a la IA da respuestas distintas
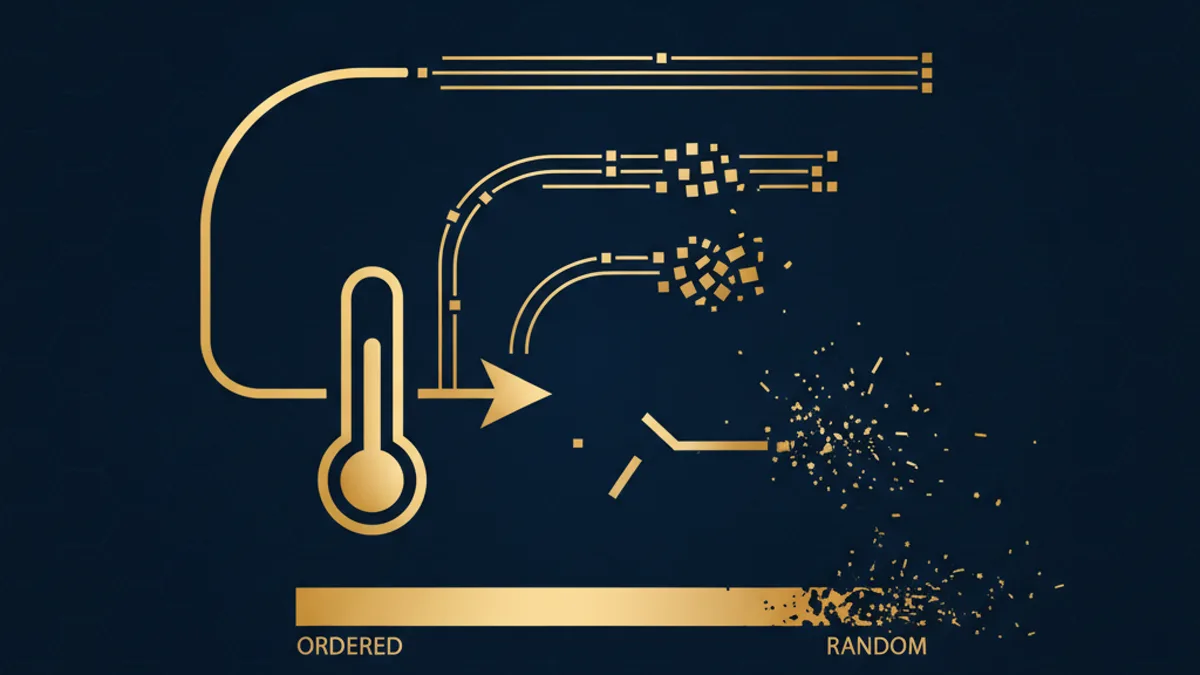
Haz la misma pregunta a un sistema de IA dos veces y puedes recibir dos respuestas diferentes. No es un error ni un capricho: es una decisión de diseño, gobernada por un parámetro llamado temperatura. La temperatura regula cuánta libertad se concede el modelo al elegir la palabra siguiente: baja y las respuestas se vuelven previsibles y repetibles, alta y se vuelven variadas y creativas pero menos estables. Entender este parámetro explica de golpe muchas cosas que parecen extrañas: por qué un modelo a veces inventa, por qué dos intentos no coinciden, por qué la misma petición rinde mejor en un momento y peor en otro. No es un detalle para técnicos: es la razón por la que no puedes juzgar un sistema de IA por una sola respuesta, y por la que comparar varias perspectivas vale más que el intento afortunado aislado.
El límite del conocimiento: qué no puede saber un modelo de IA
Todo modelo de IA tiene una frontera invisible más allá de la cual no ha aprendido nada: la fecha hasta la que fue entrenado, el llamado límite del conocimiento (knowledge cutoff). Todo lo que ha ocurrido después de esa fecha, para el modelo, sencillamente no existe. Y junto a esa frontera temporal hay otras dos, aún más insidiosas: el modelo no conoce tu contexto privado y no sabe lo que no sabe. El resultado es un sistema capaz de escribir con la misma seguridad tanto lo que ha aprendido bien como lo que ignora por completo. Entender dónde pasan estas fronteras no es un detalle técnico: es la diferencia entre usar un modelo con criterio y fiarte a ciegas de una respuesta que suena bien pero se apoya en el vacío.
Guardrails: cómo mantener un sistema de IA dentro de los carriles
Un modelo de lenguaje, dejado a su aire, puede escribir cualquier cosa: es su fuerza y a la vez su límite. Los guardrails (las barreras de seguridad) son el conjunto de reglas, controles y restricciones que mantienen un sistema de IA dentro de los carriles, es decir, dentro de lo que debe hacer y lejos de lo que no debe hacer. No son un detalle para especialistas: son la diferencia entre un sistema en el que puedes confiar para trabajar y un generador impredecible que te obliga a revisar cada línea. Entender qué son, dónde se colocan y por qué un guardrail por sí solo no basta es lo que separa un juguete brillante de una herramienta sobre la que construir decisiones.
Multimodalidad: cuando la IA une texto, imágenes y voz
Durante años la IA fue sobre todo una cuestión de texto: escribías, leía, te respondía. La multimodalidad (multimodality) rompe esa frontera: un modelo que trata a la vez palabras, imágenes, audio y voz, acercándose a la forma en que nosotros percibimos de verdad el mundo. Es un salto tecnológico concreto, que cambia los flujos de trabajo y abre usos impensables hasta hace poco. Pero cuanto más un modelo une los sentidos, más fácil es olvidar un límite que permanece: incluso el modelo más completo te ofrece igualmente una sola perspectiva sobre el problema. Entender qué cambia con la multimodalidad y qué en cambio no cambia es la manera correcta de usarla sin hacerse ilusiones.
La ventana de contexto: qué puede ver realmente un modelo de IA
Cuando le escribes a una IA imaginas que te está escuchando como lo haría una persona, con toda la conversación bien presente. En realidad cada modelo trabaja dentro de una ventana de contexto: un espacio limitado que contiene lo que puede tener en cuenta en ese momento. Todo lo que está dentro de la ventana el modelo lo ve; todo lo que queda fuera, para él simplemente no existe. Entender cómo funciona este espacio cambia la forma en que usas la herramienta: explica por qué a veces parece olvidar, por qué una ventana más grande no equivale a más comprensión, y por qué lo que eliges poner dentro pesa más que su tamaño.
Meta-layer: qué mantiene unido el flujo de varias IA
Cuando pones a trabajar varias IA sobre el mismo problema, lo difícil no es conseguir las respuestas: es mantenerlas unidas. Cinco voces buenas que escriben cada una en su rincón siguen siendo cinco monólogos hasta que alguien las alinea, entiende dónde convergen y dónde divergen, y decide qué llevar adelante. Si ese alguien eres tú, a mano, la ventaja de tener varias perspectivas se pierde en el trabajo de recomponerlas. El meta-layer es el nivel superior que hace justo eso: toma respuestas separadas y las convierte en un flujo legible que avanza hacia una decisión. No es un detalle estético, es la arquitectura que decide si tener varias IA de verdad te ayuda o te sepulta.
Comparación estructurada frente a conversaciones sueltas y desconectadas
Cuando una decisión importa, el reflejo más común es preguntar lo mismo a varias IA distintas: abres unas pestañas, pegas la pregunta, recoges las respuestas. Parece una comparación, pero no lo es. Son conversaciones sueltas y desconectadas, cada una encerrada en su contexto, que no se ven ni se hablan: el trabajo de juntarlas —alinear los puntos, ver dónde convergen y dónde divergen, decidir qué conservar— recae entero sobre ti, a mano, justo en el momento en que estás más cansado. Una comparación estructurada es otra cosa: misma pregunta, mismo contexto, respuestas puestas una junto a la otra y legibles de un vistazo, con un meta-layer que mantiene unido el flujo. La diferencia no es estética, es arquitectónica, y cambia la calidad de la decisión que sale de ahí.
Interoperabilidad: por qué no conviene atarse a un solo modelo de IA
Elegir un modelo de IA es fácil de hacer y difícil de deshacer: con el tiempo tus flujos de trabajo, tus datos y tus hábitos acaban pasando todos por un único sistema, y el día en que aparece uno mejor cambiar cuesta mucho más de lo previsto. La interoperabilidad (interoperability) es la capacidad de hacer trabajar juntos e intercambiar modelos distintos sin quedar prisionero de uno solo. No es una cuestión técnica para especialistas: es libertad estratégica, protección frente al vendor lock-in y, sobre todo, la condición que hace posible comparar varias perspectivas en lugar de confiar en una sola. Entender por qué no conviene atarse a un único modelo es el primer paso para usar la IA desde una posición de fuerza.
El razonamiento de la IA: qué pasa cuando el modelo 'piensa' en voz alta
Los sistemas de IA más recientes han aprendido a no entregar solo la conclusión, sino a mostrar el camino que lleva a la respuesta: el razonamiento en cadena (chain-of-thought). Exponer los pasos intermedios a menudo mejora la calidad en problemas complejos y hace el recorrido controlable, pero esos pasos siguen siendo texto generado, no un registro garantizado de lo que ocurre dentro del modelo. Entender la diferencia entre razonamiento como proceso y razonamiento como explicación es la clave para confiar en los resultados en su justa medida. Y cuando los razonamientos se pueden comparar, dejan de ser un monólogo que aceptar y se convierten en material para examinar.
Alucinaciones de la IA: por qué ocurren y cómo el contraste las desenmascara
Le pasa a cualquiera que use un sistema de IA: en algún momento la respuesta suena perfecta, segura, bien redactada, y precisamente por eso te fías. Luego descubres que el dato no existe o la cita es inventada. Es el fenómeno que llamamos alucinación, y no es un fallo ocasional: es una característica estructural de cómo están hechas estas tecnologías. Entender por qué ocurre es el primer paso para no dejarse engañar, y contrastar varias perspectivas complementarias es la forma más robusta de hacerla visible antes de que se convierta en una decisión equivocada.
Enrutamiento y composición: cómo varios modelos de IA pueden trabajar juntos
Durante años nos preguntamos cuál es el mejor modelo de IA, como si hubiera uno solo que sirviera para todo. Quien construye sistemas de IA dejó de razonar así: ningún modelo es el mejor en cada tarea. Surgieron dos ideas para resolverlo, el enrutamiento que dirige cada petición al modelo más adecuado y la composición que pone a varios modelos a trabajar juntos sobre el mismo problema. Veamos cómo funcionan, por qué la segunda importa más que la primera y por qué comparar perspectivas vale más que una elección oculta.
Agentic workflow: cuando la IA deja de responder y empieza a actuar
Durante años usamos la IA como un oráculo: una pregunta, una respuesta, y todo el trabajo de convertirla en algo útil quedaba de nuestro lado. Los sistemas más avanzados ya no se detienen en la respuesta: reciben un objetivo e intentan llevarlo a término, paso a paso. Es el paradigma del agentic workflow, quizá el cambio más profundo de estos años. Veamos qué significa, por qué es difícil y por qué más autonomía vuelve aún más valioso el contraste entre perspectivas.
Evaluar un sistema de IA: qué son los evals y cómo se mide de verdad la calidad de una respuesta
Una demo impecable dice muy poco sobre lo fiable que es una IA en el trabajo real. Lo que separa la impresión de la sustancia son los evals: la forma estructurada de medir cuán bien responde un sistema y en qué se equivoca. Veamos qué son, por qué se están convirtiendo en el corazón de quien construye IA seria y cómo esta misma lógica cambia el modo en que decides en quién confiar.
Modelos especializados o generalistas: el falso dilema de la IA
Al elegir una herramienta de IA solemos preguntarnos si conviene un modelo generalista, capaz de hacer un poco de todo, o uno especialista, entrenado a fondo en un único dominio. Parece una cuestión técnica, pero decide la calidad del trabajo de cada día: amplitud contra profundidad, con sus compromisos ocultos. Y quizá, hoy, sea la pregunta equivocada.
Memoria y contexto largo en los flujos de IA: recordar no es entender
Cada conversación con una IA empieza de cero: el modelo solo ve lo que entra en su ventana de contexto. Ampliarla y añadir memoria cambió lo que podemos pedirle, pero más contexto no significa más comprensión, y una memoria larga sobre una sola voz no corrige sus errores: los vuelve coherentes. La diferencia la marca sostener varias perspectivas a la vez, no recordar más.
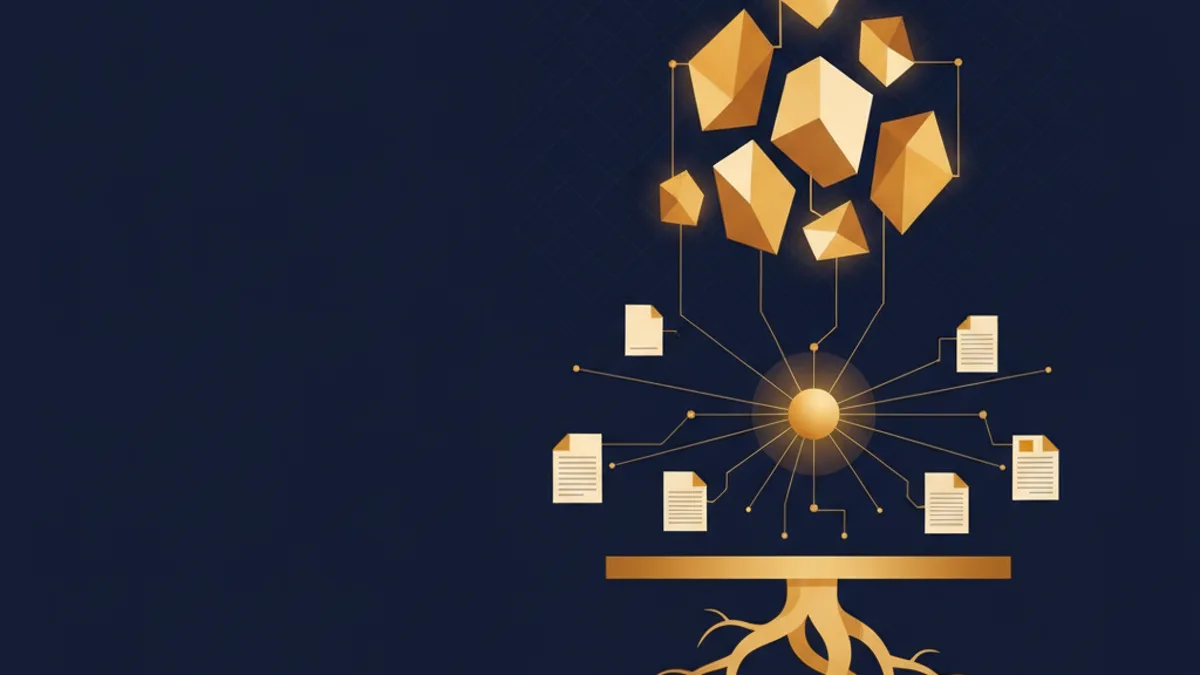
Grounding y RAG: darle raíces a las respuestas de la IA
Un modelo de IA escribe a partir de lo que memorizó durante el entrenamiento: un conocimiento potente pero cerrado, detenido en un punto del tiempo y propenso a llenar los vacíos con respuestas plausibles pero no verificadas. El grounding y el RAG son la forma de anclar esas respuestas a fuentes reales y comprobables, dando raíces a lo que de otro modo quedaría suspendido en el aire.
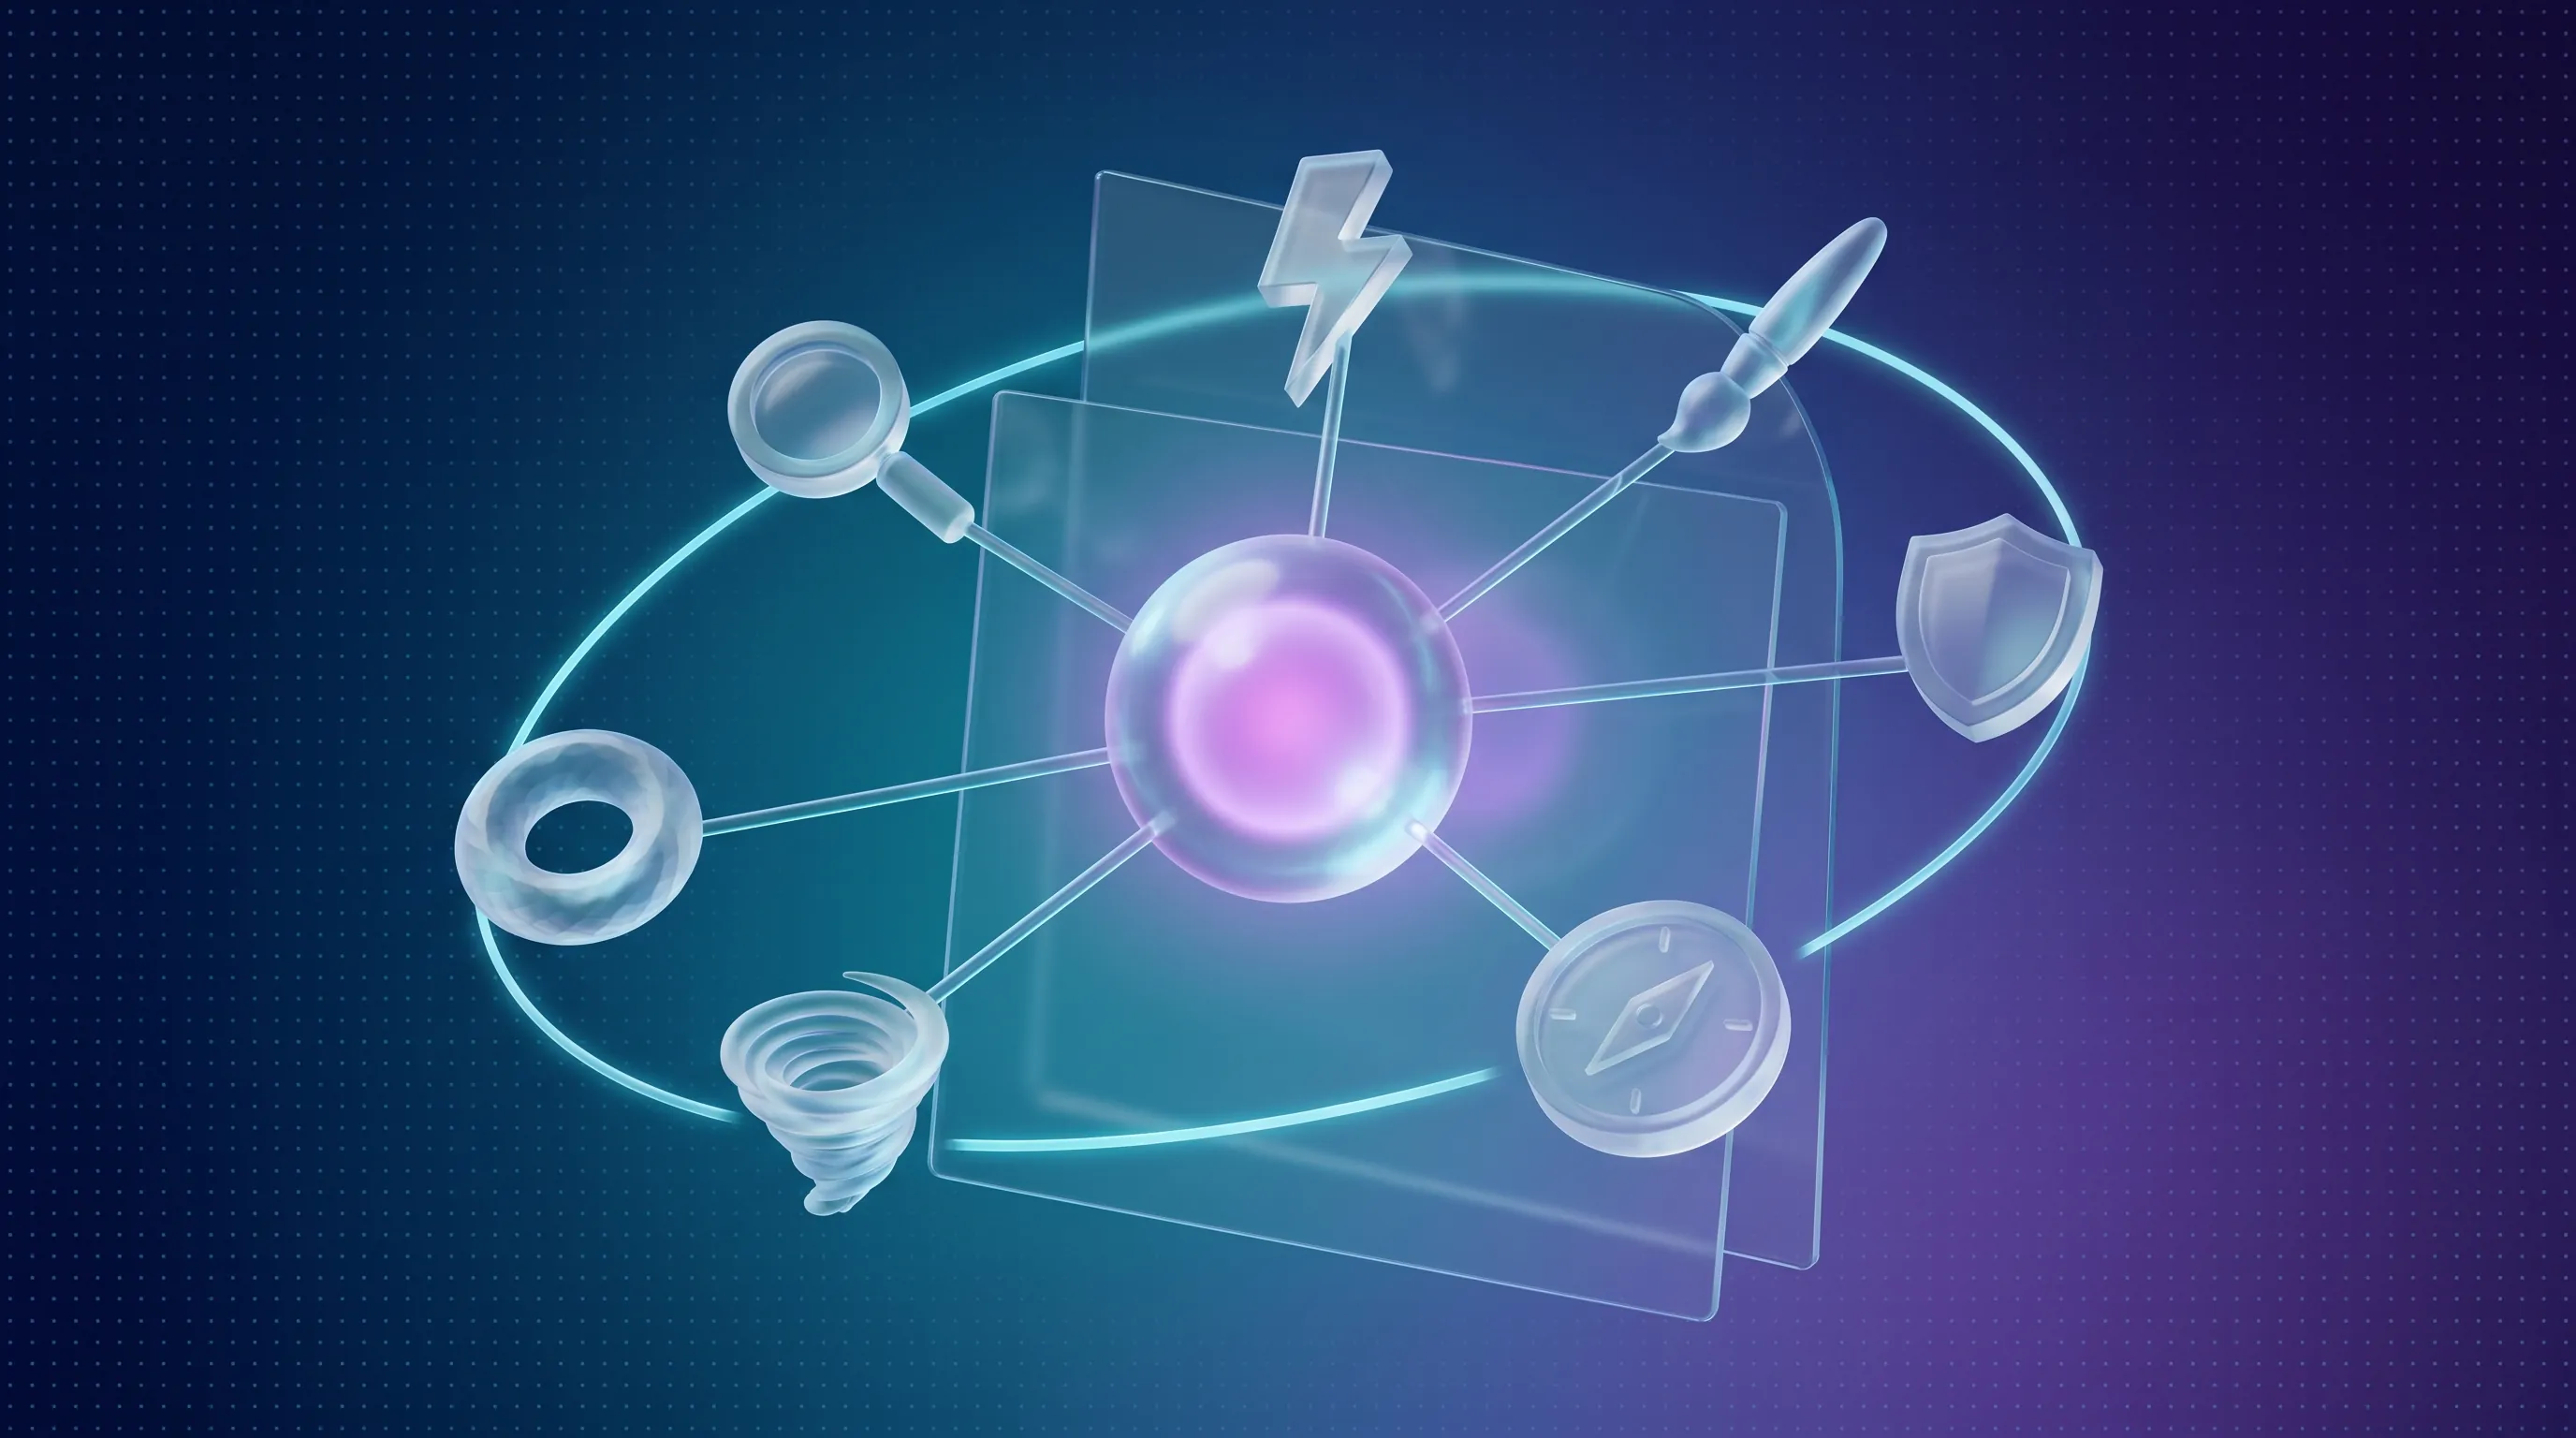
Especialistas complementarios: un equipo de agentes para las decisiones complejas
No basta con tener muchos modelos de IA. Se necesitan roles estructuralmente diferenciados: analista, creativo, crítico, pragmático, visionario, contrarian, sintetizador. La diversidad útil no es meramente superficial, sino unprompt engineeringo por cada uno de estos roles. ¿Qué cambia cuando un equipo complementario trabaja conjuntamente en un mismo problema?
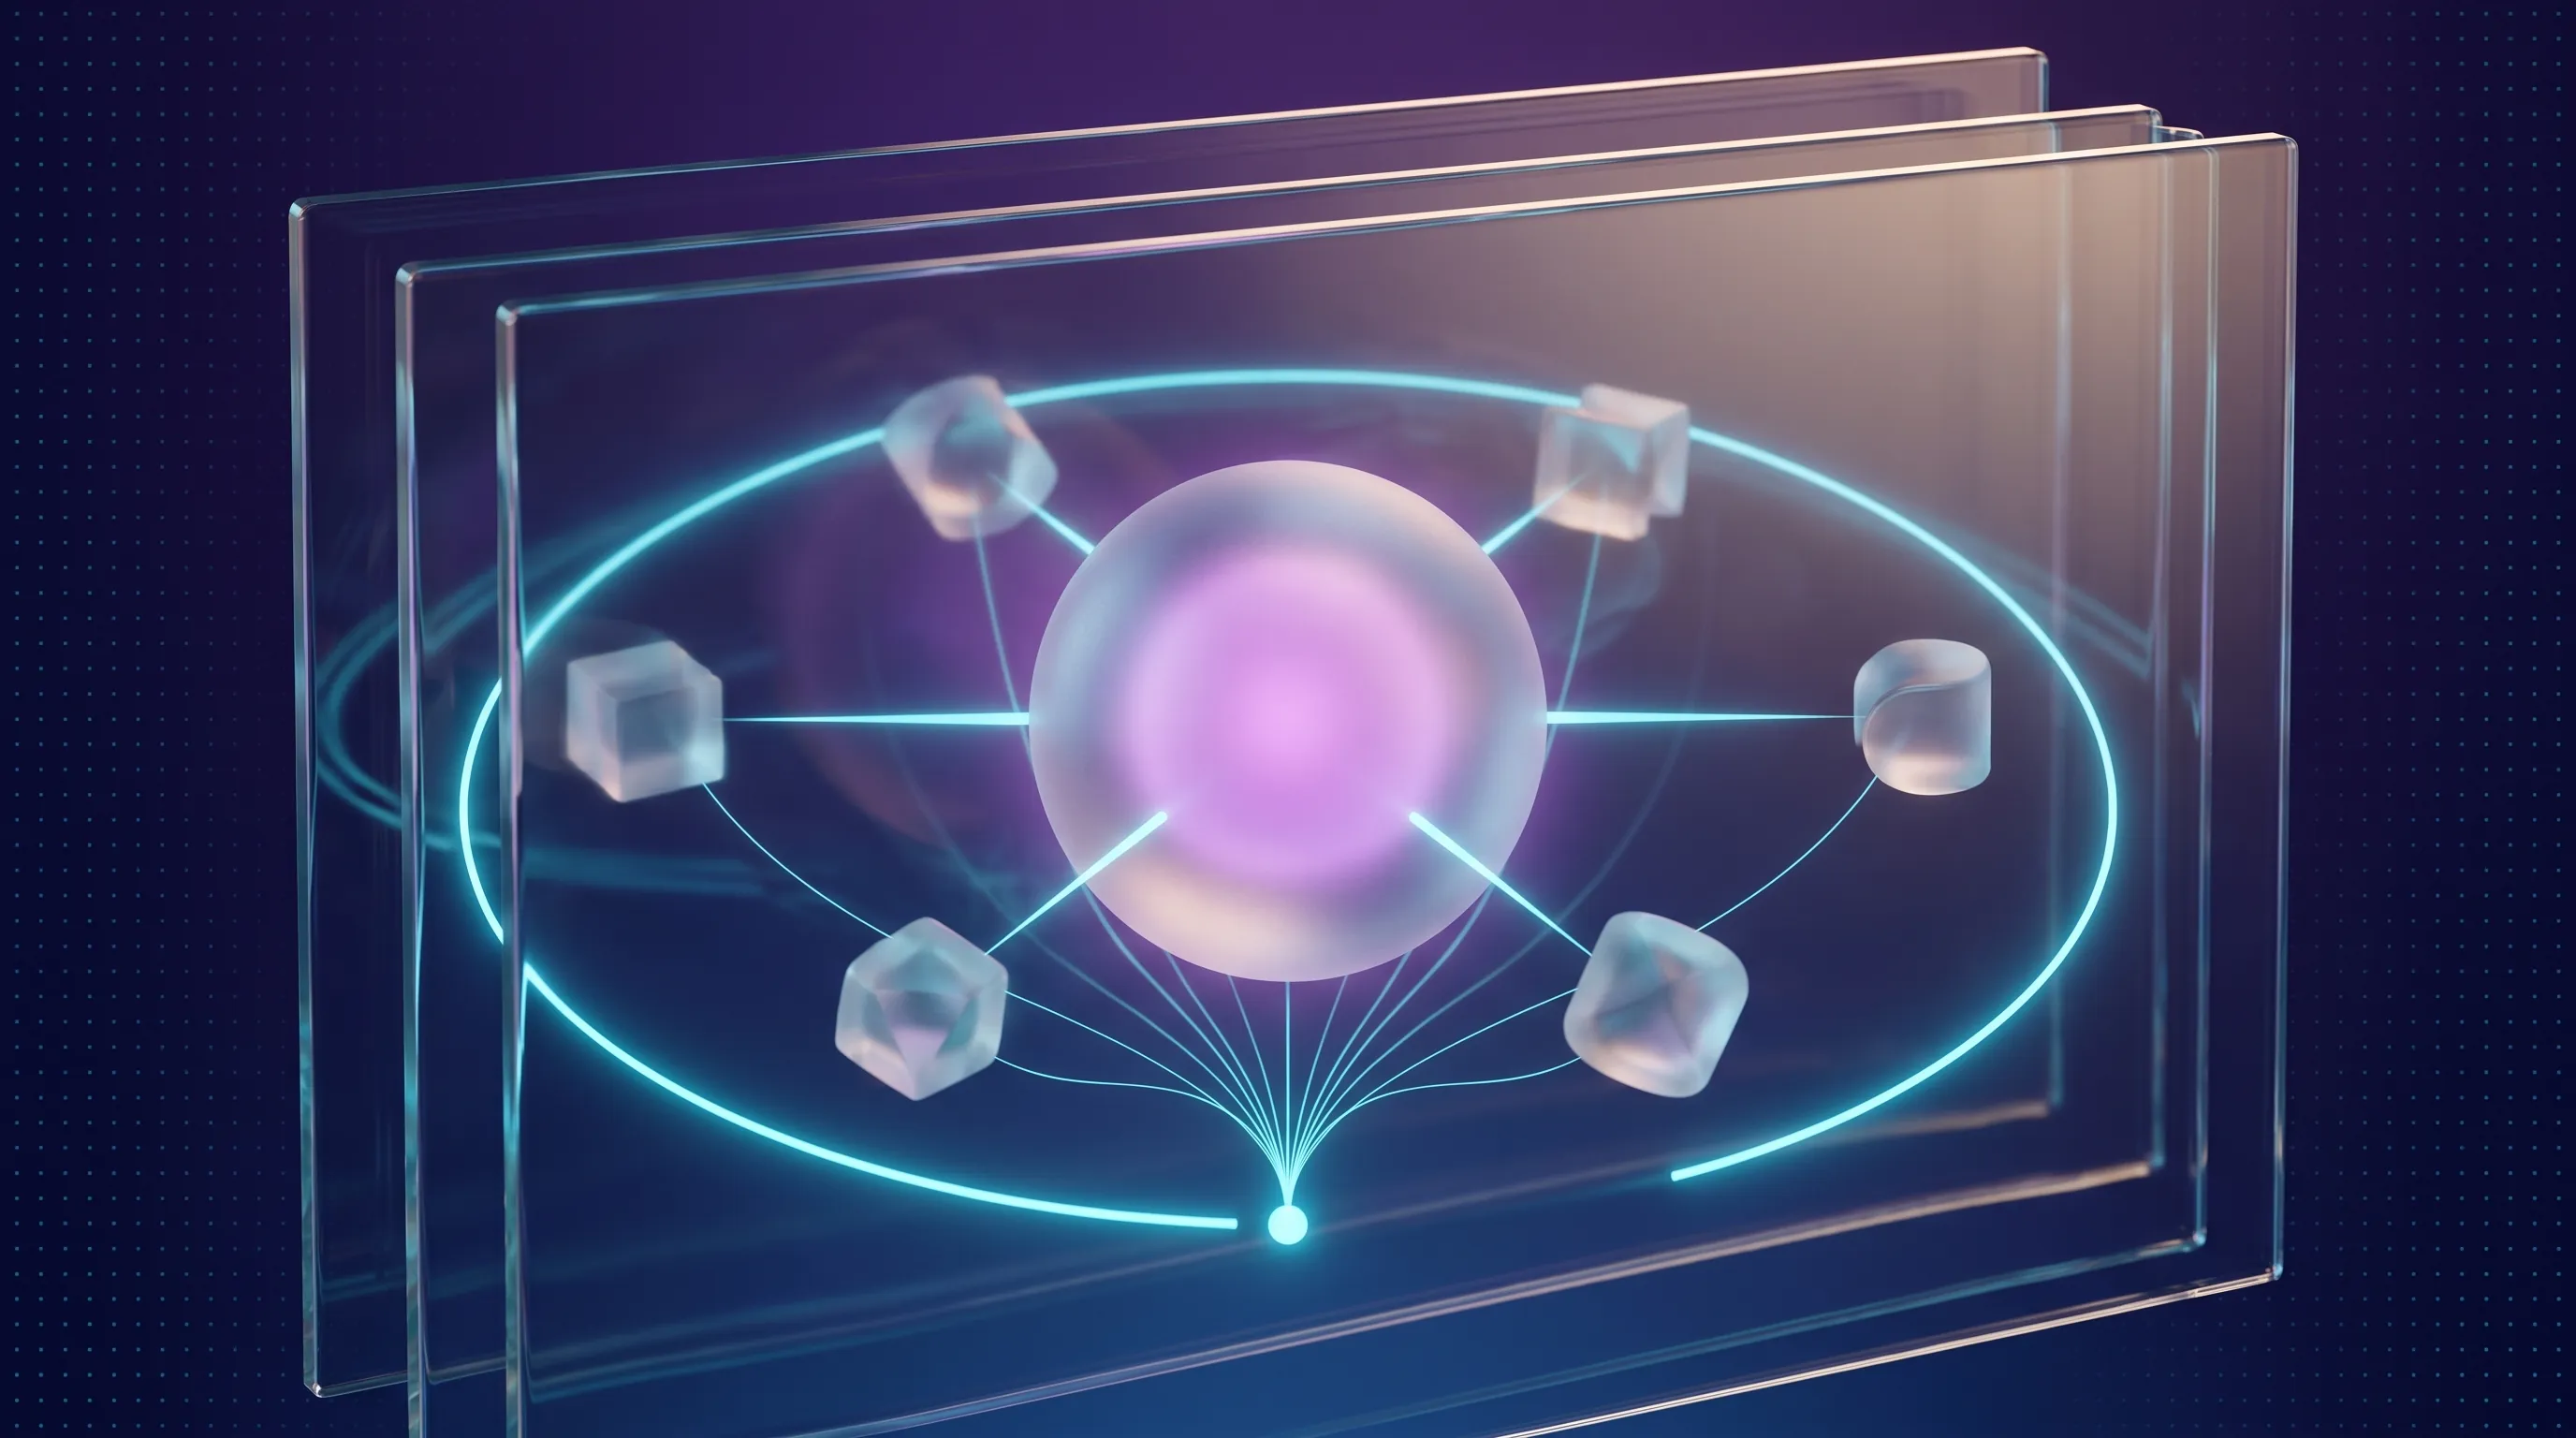
La Orchestrator: la arquitectura que distingue a Arena de las IA de instancia única
Una conversación de IA individual es una sola voz a la vez. Un sistema «multi-agent» y sin coordinación es ruido paralelo. El «Orchestrator» es el nivel que pone en diálogo muchas respuestas, destaca las convergencias y divergencias, redacta el informe final y propone la siguiente pregunta. ¿Qué cambia con un nivel de inteligencia que coordina?
Decisiones en movimiento: la IA rediseñada para el flujo de trabajo diario
Las decisiones no esperan a que te sientes ante el escritorio. Se toman sobre la marcha, entre una reunión y otra, en el metro o haciendo cola en la cafetería. La mayoría de las herramientas de IA están diseñadas principalmente para el escritorio, con una adaptación responsiva. Arena ha rediseñado la experiencia de usuario para el manejo táctil y el flujo de trabajo. ¿Qué cambia para quienes toman las decisiones?
¿Cansado de trabajar con tantas pestañas abiertas en el navegador? Pregunta a varias IA a la vez
Una ficha para cada IA, copiar y pegar para comparar, conversaciones aisladas y desconectadas. AI Arena agrupa el flujo en una sola vista, con varios agentes que colaboran escribiendo en paralelo sobre el mismo problema.
Agentes con perfiles bien definidos: equipos especializados en análisis en profundidad
Analista, creativo, pragmático, crítico, visionario, abogado del diablo, sintetizador: en AI Arena, los agentes desempeñan funciones cognitivas distintas y se combinan en equipos listos para usar en cualquier ámbito de toma de decisiones.
La ventaja de las respuestas en paralelo: por qué una sola IA te limita
Una sola inteligencia artificial te ofrece una única perspectiva. Comparar varios agentes complementarios en paralelo reduce los errores, pone de manifiesto los sesgos ocultos y enriquece el proceso de toma de decisiones.
Todos los temas